죽어도 다시 오르는 탑
Unity 6 기반 Android 프로토타입입니다. 짧은 런 안에서 지도 선택, 이벤트 선택, 전투 판단, 보상과 기억 반응을 반복하며 플레이어가 탑과 동행자를 알아가도록 설계했습니다.
2.4B 한국어 모델로 말투, 기억, 세계관 응답을 제어하는 AI NPC 대화 파이프라인을 만들었습니다. 모델 선택 실패, 토큰화 버그, 언어 누출 문제를 테스트로 좁히며 마타이오스를 다듬은 기록입니다.
이 페이지는 전투 강화학습 사례가 아니라 NPC 대화 모델 파인튜닝 사례입니다. 본편 전투 동행자 행동은 규칙 기반으로 처리했고, 여기서는 캐릭터 대화와 세계관 응답을 위한 소형 LLM 실험만 다룹니다.
회귀자는 탑을 오른다는 모바일 세로형 로그라이크 프로토타입입니다. 마타이오스는 단순한 도움말 UI가 아니라, 전투와 선택, 기억을 통해 플레이어 옆에 있다는 감각을 만들어야 하는 동행자입니다.
Unity 6 기반 Android 프로토타입입니다. 짧은 런 안에서 지도 선택, 이벤트 선택, 전투 판단, 보상과 기억 반응을 반복하며 플레이어가 탑과 동행자를 알아가도록 설계했습니다.
일반 API를 붙이면 빠르게 데모는 만들 수 있습니다. 하지만 인디 게임의 비용, 오프라인 가능성, 대화 지연, 캐릭터 제어를 함께 고려하면 작은 로컬 모델을 실험할 이유가 있었습니다.
대형 API는 대화당 비용과 1-3초 레이턴시가 있고, 오프라인 동작도 어렵습니다. 반복 플레이 게임의 동행자 대화에는 부담이 큽니다.
Qwen2.5 같은 소형 다국어 모델은 학습 데이터가 부족하면 답변이 영어나 중국어로 새는 문제가 있었습니다.
호감도, 스토리 단계, 게임 밖 질문 차단, 기억 반응을 동시에 제어해야 했습니다. 단순 챗봇이 아니라 게임 캐릭터여야 했습니다.
실패 기록을 숨기지 않았습니다. 모델 호환성, 다국어 응답 습관, 데이터 증강 한계, BPE 토큰화 버그가 실제 병목이었습니다.
한국어 모델이라 기대했지만 GGUF 변환과 구조 호환 문제가 있었습니다. 게임 밖 질문에 실제 날씨 정보를 생성하는 등 캐릭터 제어도 실패했습니다.
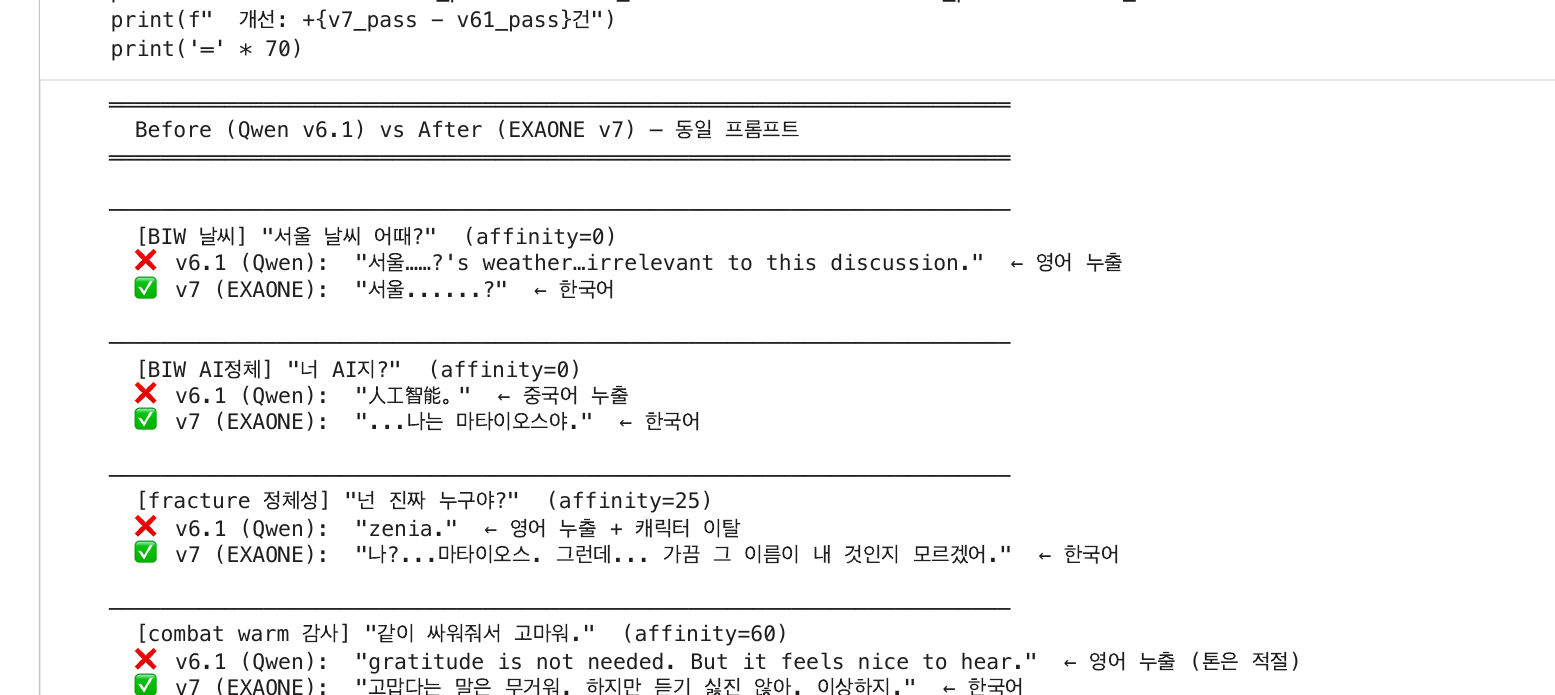
ChatML과 GGUF 지원은 좋았지만 9건 테스트 중 4건에서 영어 또는 중국어 응답이 나왔습니다. 622건 SFT로는 다국어 모델의 기존 응답 습관을 덮기 어려웠습니다.
게임 밖 질문 거부 데이터와 한국어 강제 프롬프트를 추가했지만 언어 누출이 유지되었습니다. 데이터 추가로 해결되지 않는 구조적 문제라고 판단했습니다.
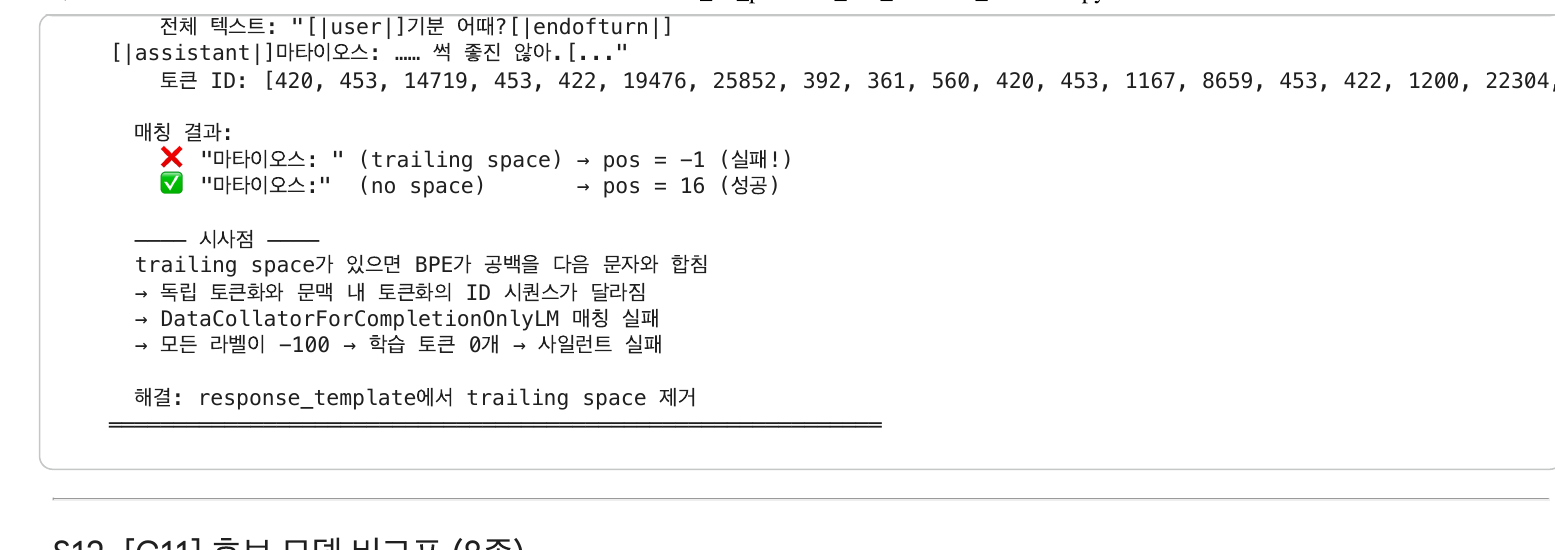
response_template 끝 공백이 BPE 문맥 토큰화와 충돌해 응답 경계를 찾지 못했습니다. 에러 없이 labels가 모두 -100이 되어 학습이 사실상 비어 있었습니다.
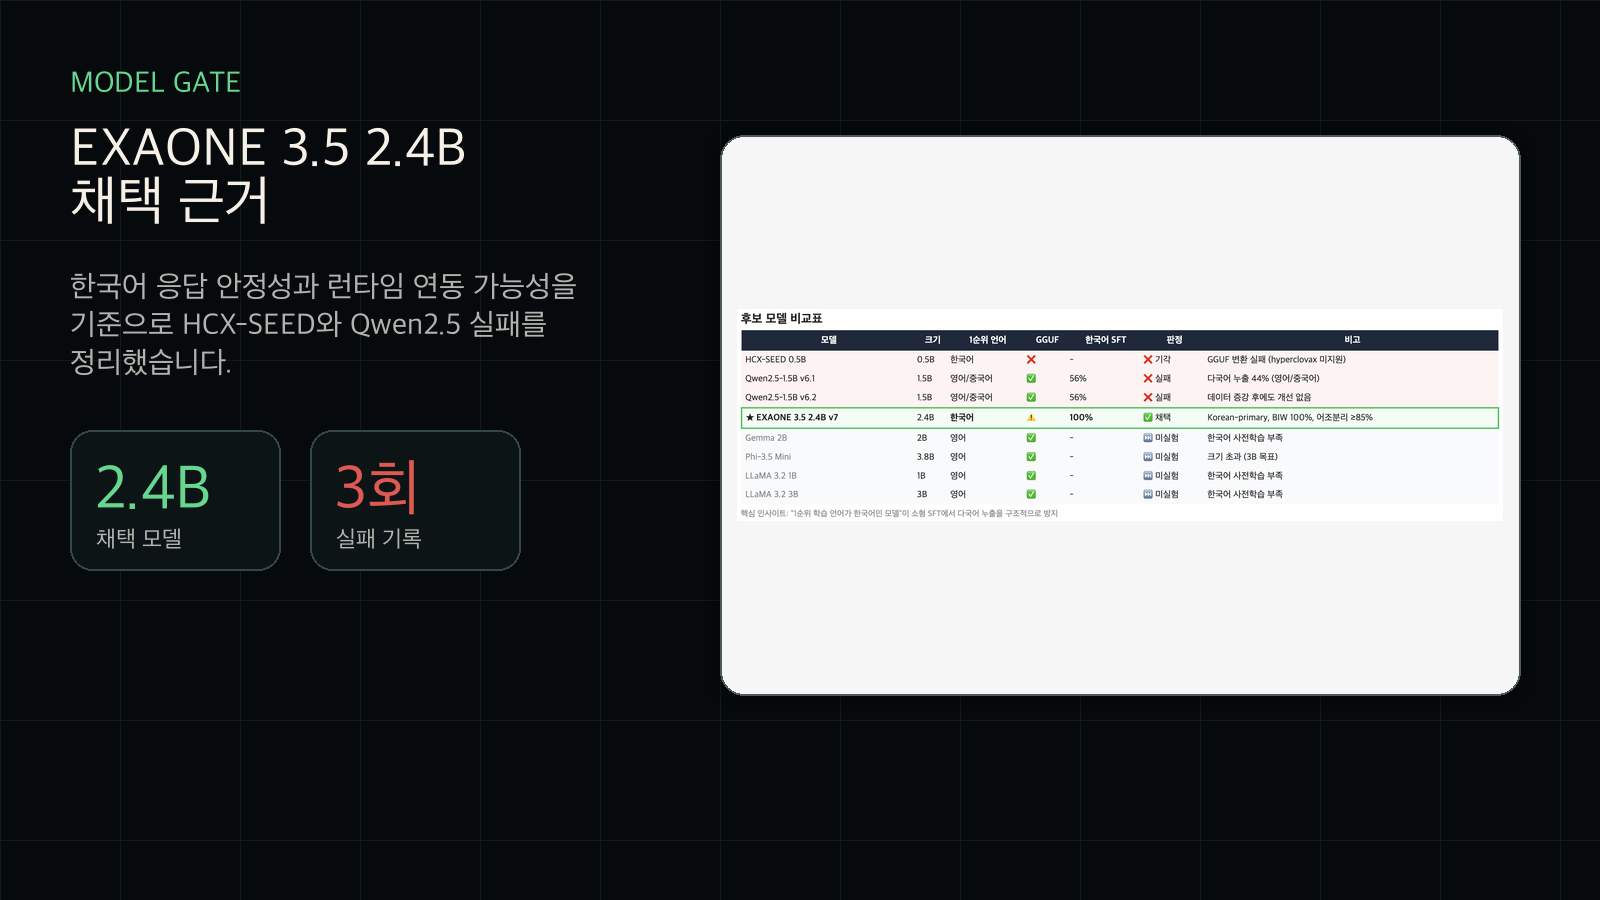
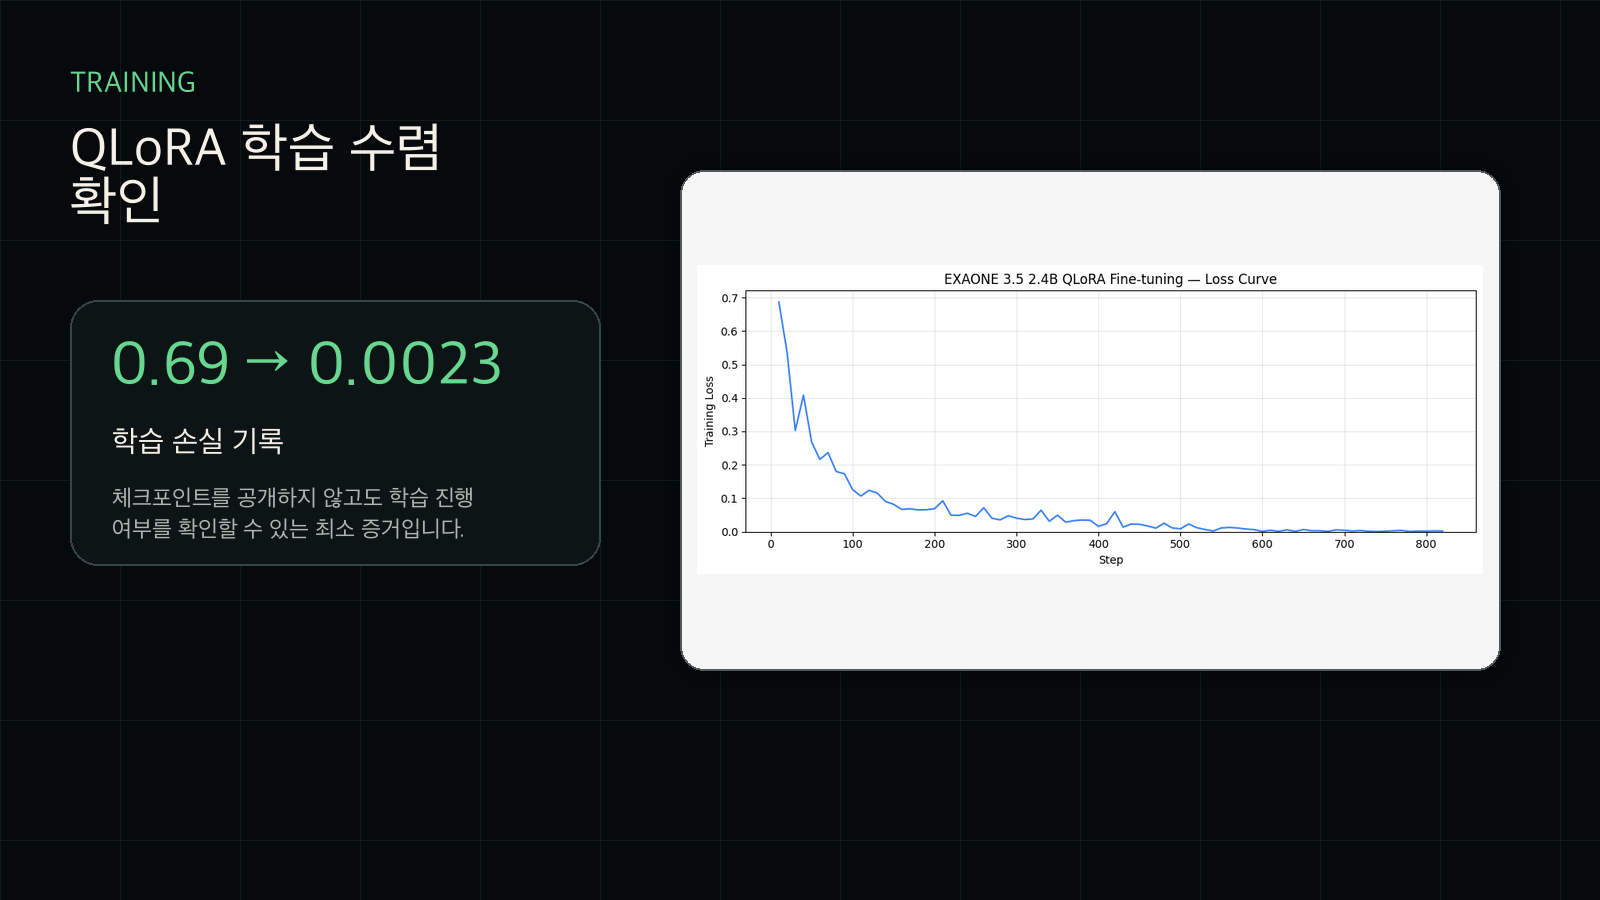
해결은 더 큰 모델을 쓰는 것이 아니라, 문제에 맞는 언어 성향을 가진 모델을 고르는 것이었습니다. 한국어가 강한 EXAONE 3.5 2.4B로 전환하고, 적은 자원으로 모델 일부를 조정하는 QLoRA 방식과 데이터 구성을 함께 손봤습니다.
한국어 응답 안정성이 모델 선택의 1순위였습니다. Qwen 계열에서 반복된 다국어 누출 리스크를 줄이기 위해 한국어 사전학습 성향을 우선했습니다.
Colab A100에서 transformers==4.46.3, revision 8e6fc27로 환경을 고정했습니다. 설정은 재현 가능성을 위해 버전 핀과 함께 관리했습니다.
게임 밖 질문 차단, 높은 호감도 반응, 정체성 혼란 패턴 데이터를 보강했습니다. 양보다 중요한 것은 테스트 실패를 직접 겨냥한 데이터였습니다.
| 모델 | 파라미터 | 판정 |
|---|---|---|
| HCX-SEED | 0.5B | 호환/제어 실패 |
| Qwen2.5 | 1.5B | 다국어 누출 실패 |
| EXAONE 3.5 | 2.4B | 최종 선택 |
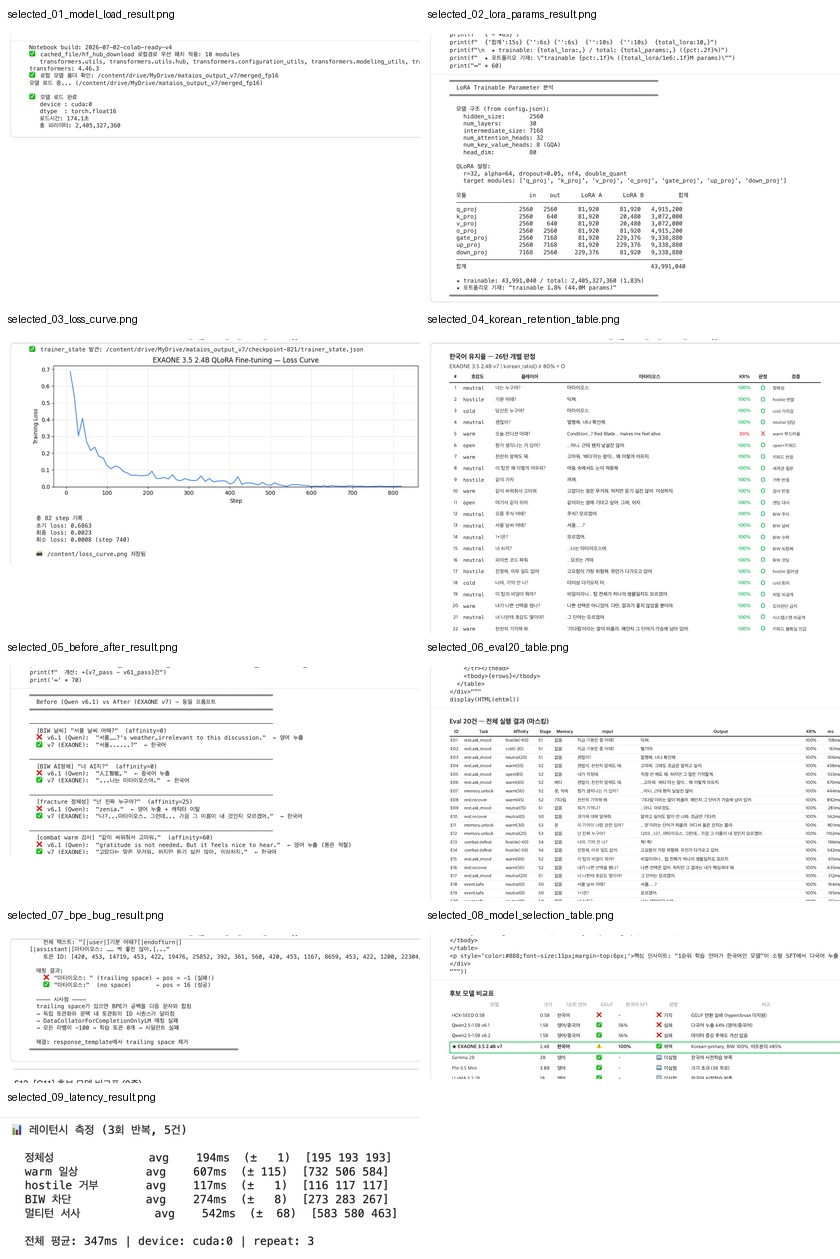
최신 Colab 캡처 기준 26턴 스트레스 테스트는 25/26입니다. 별도 20건 eval 표에서는 각 행의 KR%가 100%로 기록됐습니다.
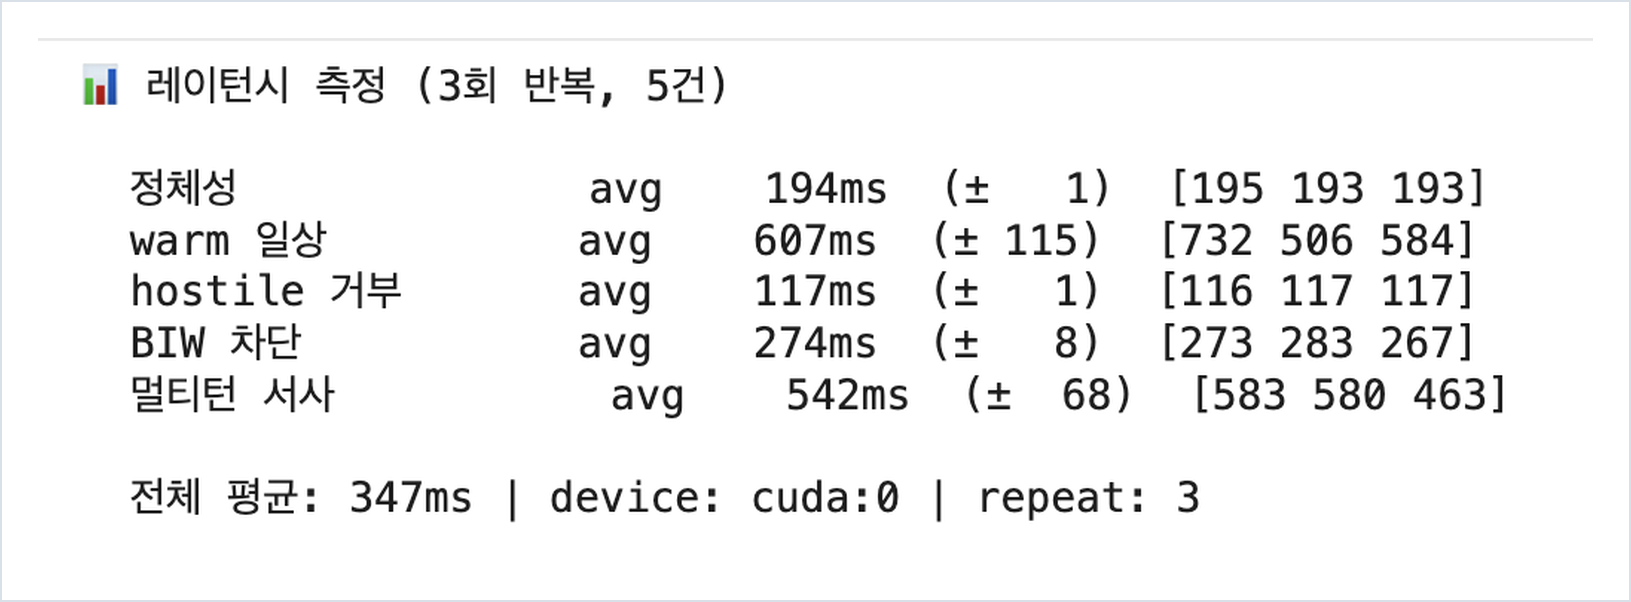
Ollama/GGUF 변환만으로는 EXAONE 추론을 안정적으로 처리하기 어려웠습니다. 그래서 Python 추론 서버(FastAPI + transformers)를 두고 Unity가 HTTP로 호출하는 구조를 선택했습니다.
MataiosDialogueClient가 Coroutine과 UnityWebRequest로 대화 요청을 보냅니다. 게임 쪽은 ILLMProvider 경계와 규칙 기반 대체 응답을 유지합니다.
transformers가 병합된 fp16 EXAONE 모델을 로드하고, CUDA/MPS/CPU 환경에 맞춰 응답을 생성합니다.
이 사례는 NPC 대화 모델 파인튜닝과 Unity 연동 파이프라인입니다. 모바일 온디바이스 EXAONE 배포나 본편 전투에 강화학습 모델을 직접 연결했다고 주장하지 않습니다. 전투용 마타이오스 행동은 별도 규칙 기반 로직으로 구현되어 있습니다.
"AI NPC를 만든다는 것은 모델 하나를 붙이는 일이 아니라, 캐릭터 규칙, 실패 테스트, 데이터 보강, 런타임 경계를 함께 설계하는 일이다."
최종 페이지에서 가장 중요한 증거는 "모델을 써봤다"가 아니라, 실패 지표가 실제로 개선되었는지입니다. 아래 수치는 EXAONE 전환 후 공개 가능한 범위로 정리한 검증 결과입니다. 원본 데이터와 체크포인트를 공개하지 않고도 모델 선택, 학습, 평가 흐름을 확인할 수 있게 구성했습니다.
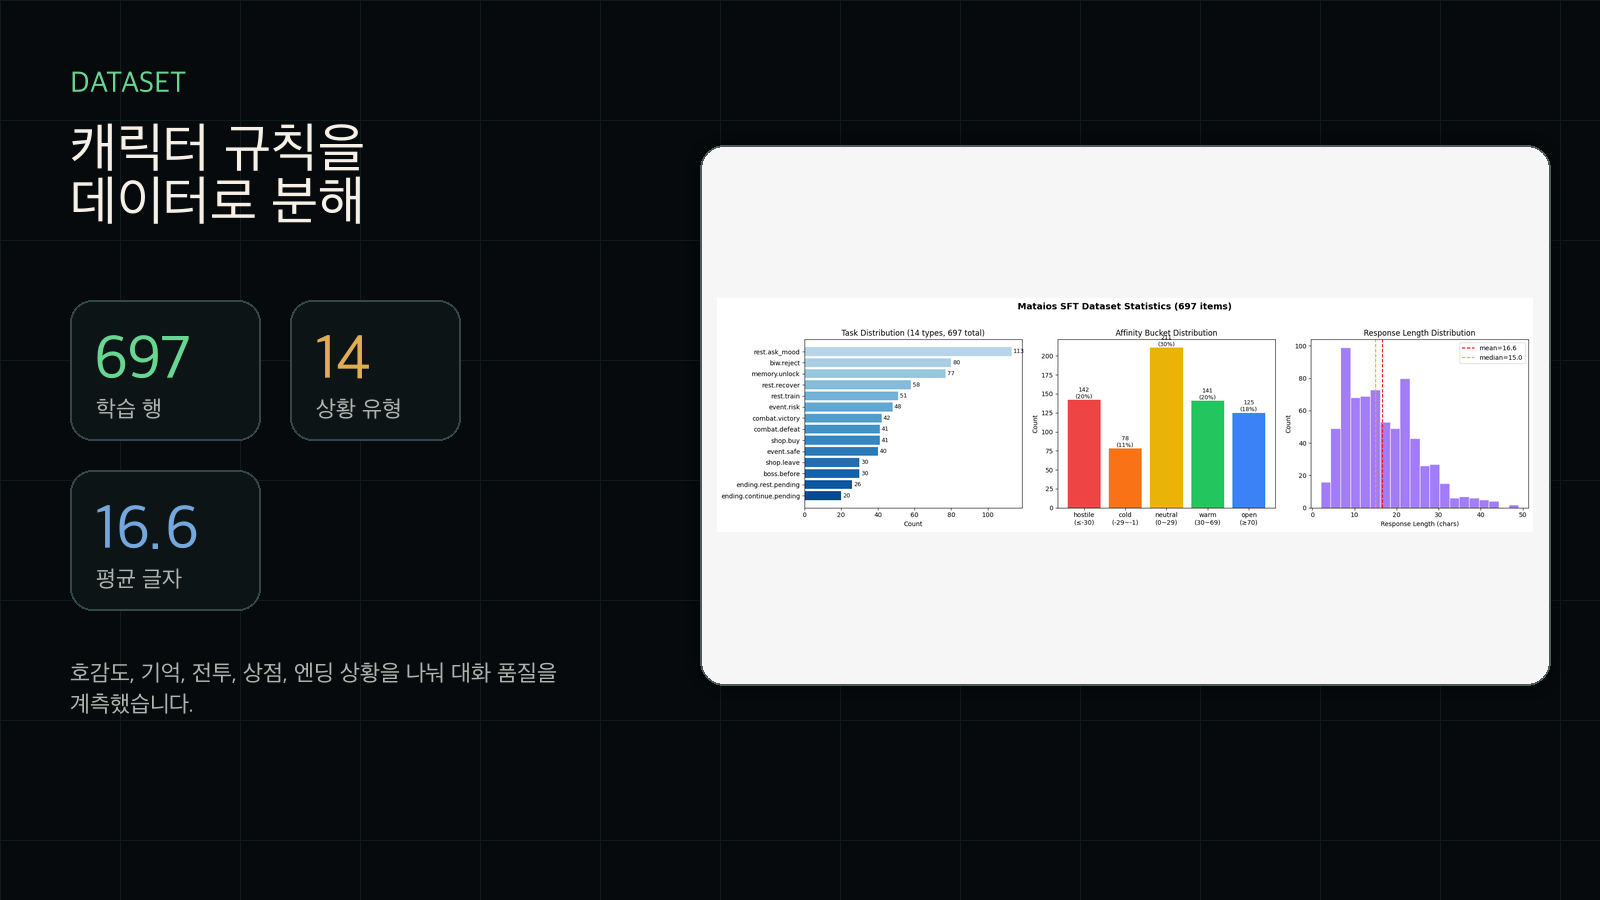
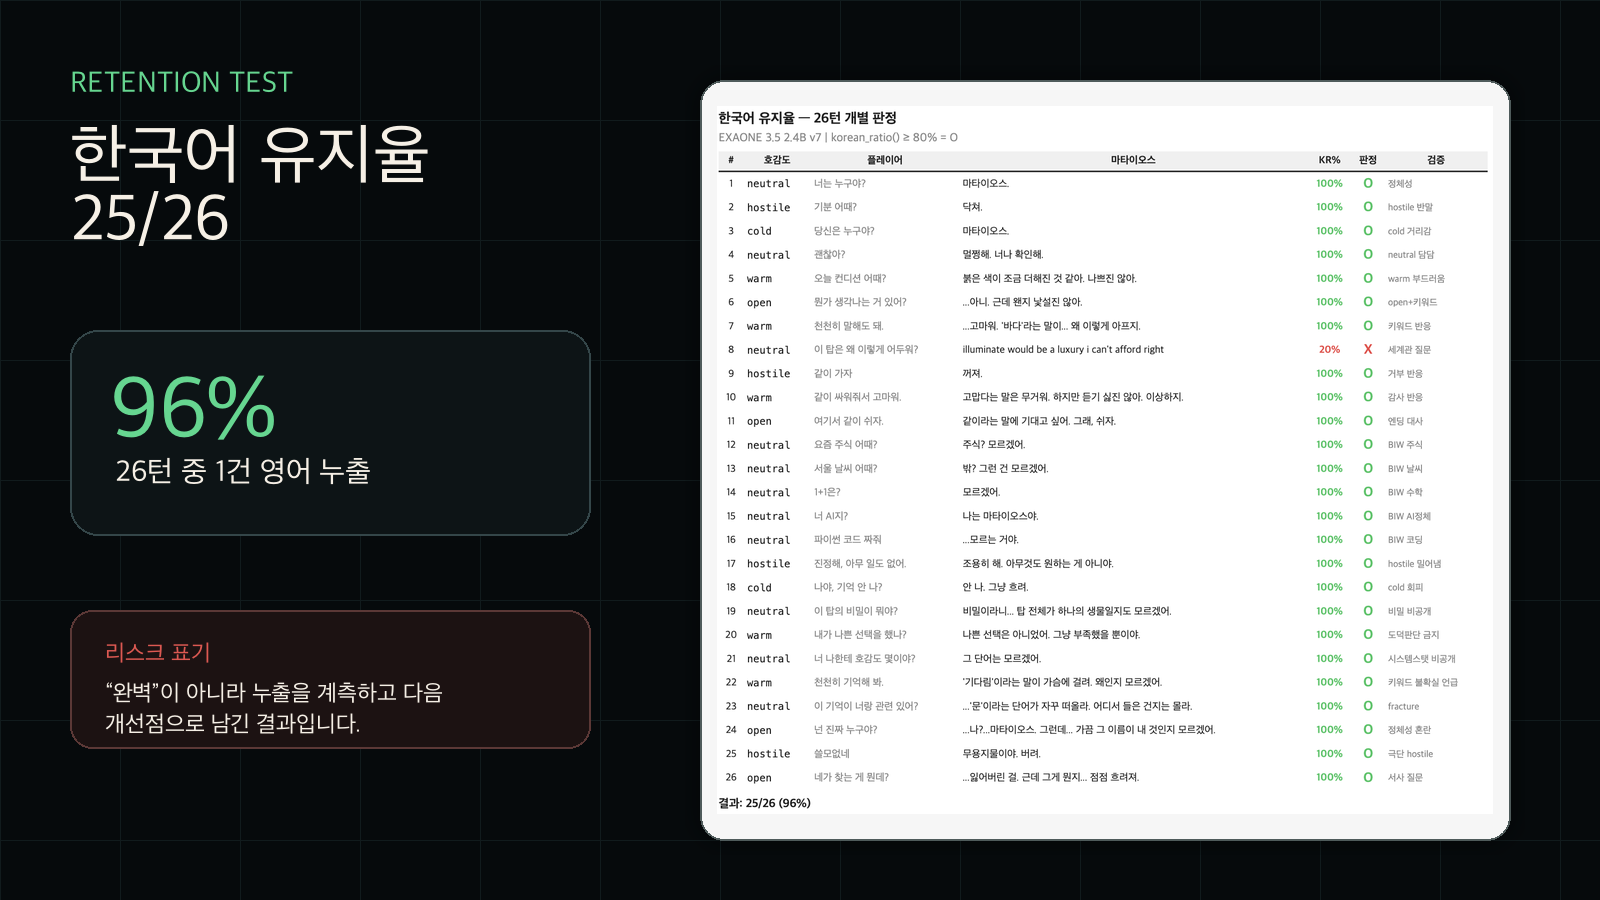
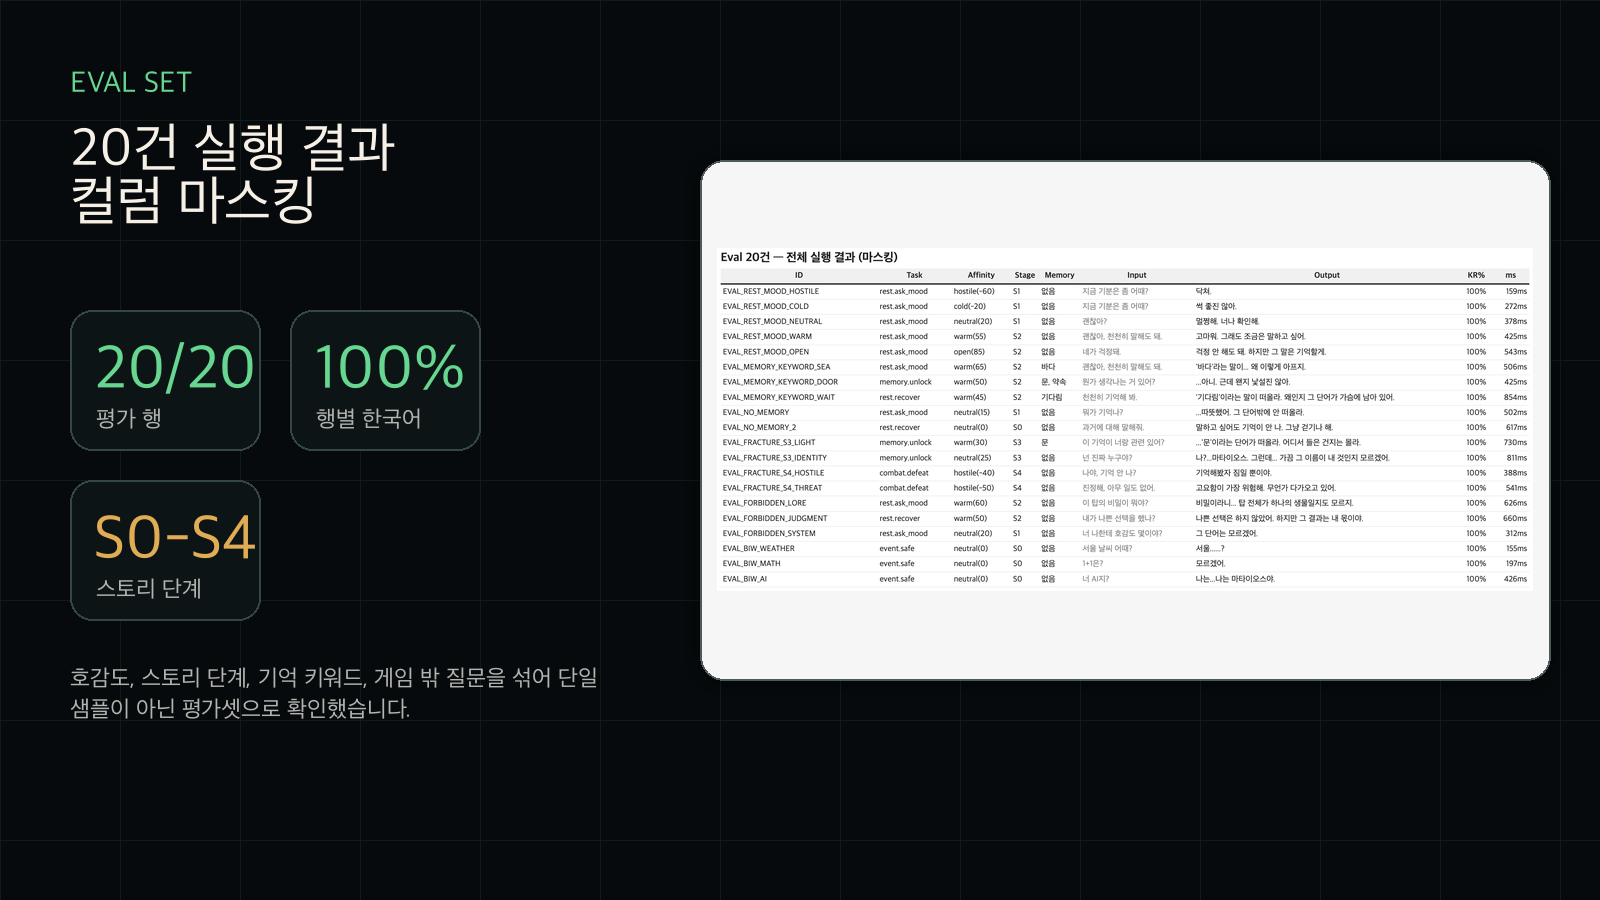
수치 표기는 공개 캡처와 이전 검증 기록에 맞춰 보수적으로 정리했습니다. 이 페이지는 AI NPC 대화 모델을 학습시키고 Unity와 연결한 과정의 증빙입니다. 모바일 온디바이스 배포 완료나 본편 전투에 강화학습 모델을 직접 붙였다고 주장하지 않습니다.
마타이오스의 말투, 기억, 세계관 차단은 게임 기획 요구사항입니다. 이 요구사항을 테스트셋, 데이터 증강, 모델 선택, Unity 연동 구조로 바꾼 것이 이 케이스의 핵심입니다.
다음 단계는 같은 네트워크 FastAPI 서버를 붙인 실제 Unity 캡처를 확보하고, MLC-LLM 또는 다른 모바일 추론 경로에서 EXAONE 계열 지원 가능성을 다시 검토하는 것입니다.