게임 소개
회귀자는 탑을 오른다는 "짧게 오르고, 선택하고, 잃고, 다시 오른다"는 감각을 전면에 둔 모바일 로그라이크입니다. 이 포트폴리오는 아이디어 소개가 아니라, 실제 APK 후보와 구현된 시스템을 바탕으로 게임 기획 역량을 보여주도록 구성했습니다.
5분 안에 가르치고, 시험하고, 비트는 플레이 루프
기획 포트폴리오 기준에 맞춰 재미를 "패턴 학습과 흥미로운 선택"으로 설명할 수 있게 재구성했습니다. 한 런은 부담 없이 시작하지만, 지도 선택과 전투 판단이 누적되며 다음 피크를 기대하게 만드는 구조를 목표로 합니다.
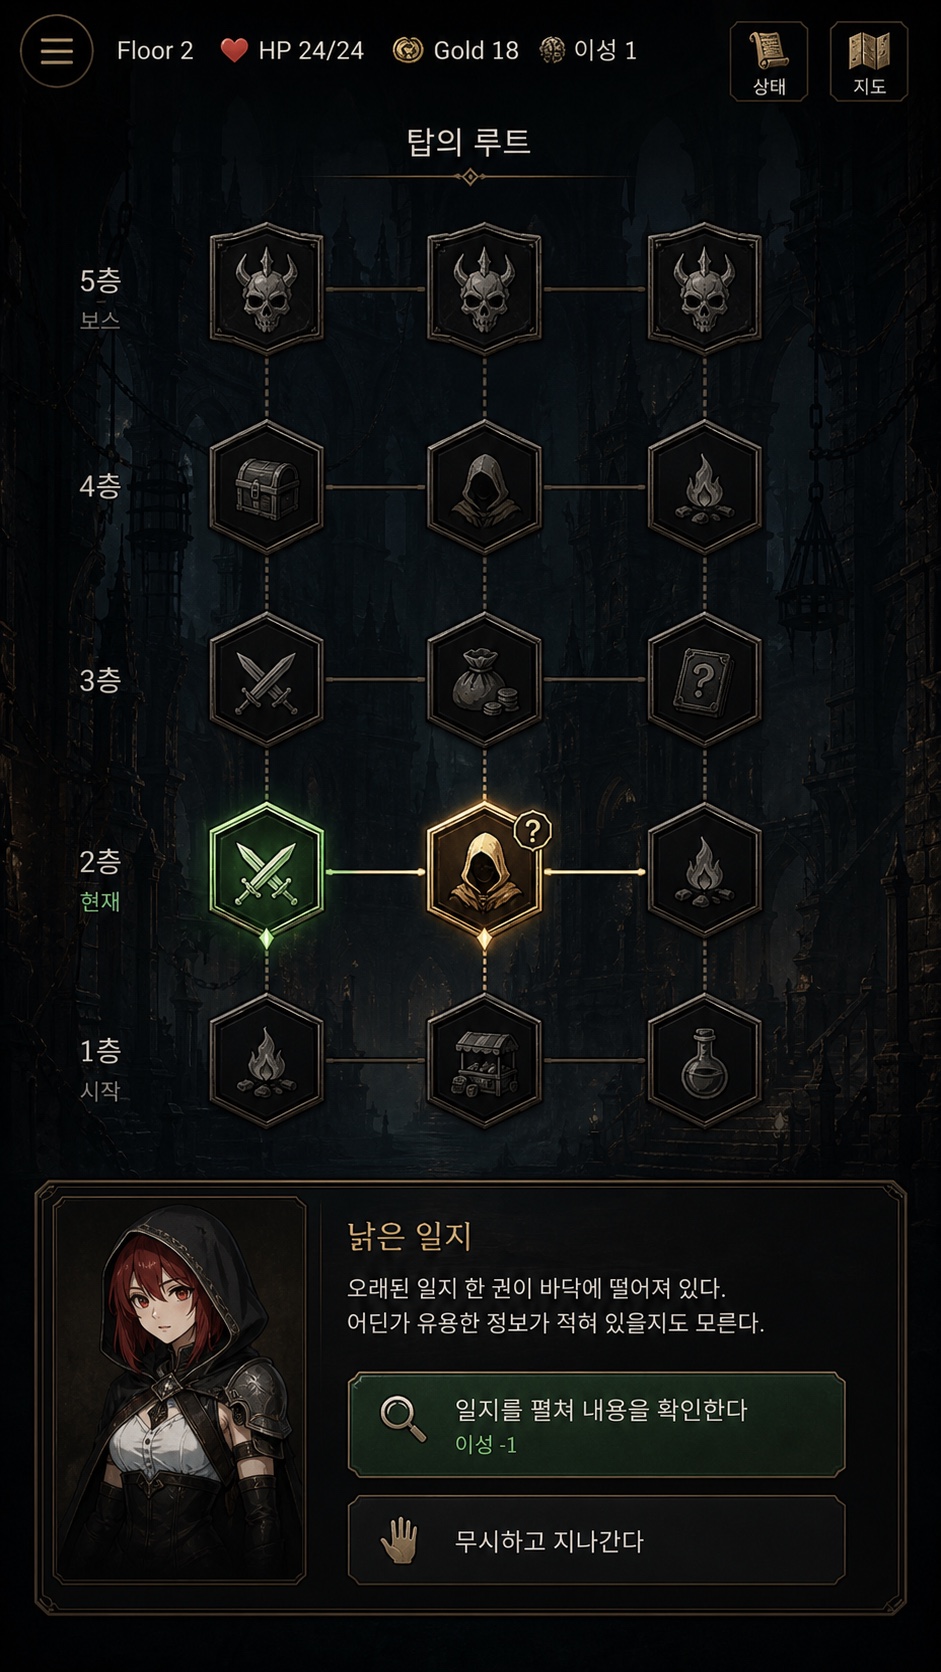
보이는 길
미래 노드 타입을 먼저 보여주고, 선택 가능한 길만 밝게 표시해 루트 규칙을 자연스럽게 학습시킵니다.
선택의 비용
이벤트 선택지는 HP, Gold, 보상, 기억 반응으로 즉시 결과를 돌려주며, 추상 점수만 쌓고 끝내지 않습니다.
전투 판단
공격만 누르는 흐름을 줄이기 위해 중압, 빈틈, 정찰, 방어 cue를 노출하고 행동별 예상값을 보여줍니다.
회복과 상실
보스 보상, 성장 선택, 마타이오스의 기억 반응이 다음 런의 기대를 만들지만, 회복은 항상 붕괴와 맞물립니다.
33
통합한 이벤트 화면
138
검증한 선택지
112 MB
최근 Android APK 후보 용량
0
본편에 연결한 ONNX/RL (없음)
미디어와 플레이 증거
현재 페이지는 실제 게임 프로젝트에 포함된 에셋만 사용합니다. 스토어 페이지처럼 게임의 장면, 동행자, 적, 이벤트 분위기를 먼저 보여주고, 이어서 GPT visual pass와 실제 Unity 프로토타입 캡처를 분리해 보여줍니다.
목표 비주얼
시스템을 먼저 만들고 검증했으며, 화면은 이 목표 비주얼을 향해 발전시키고 있습니다. 아래 세 장은 전투·루트·성장 화면이 지향하는 방향을 보여줍니다.
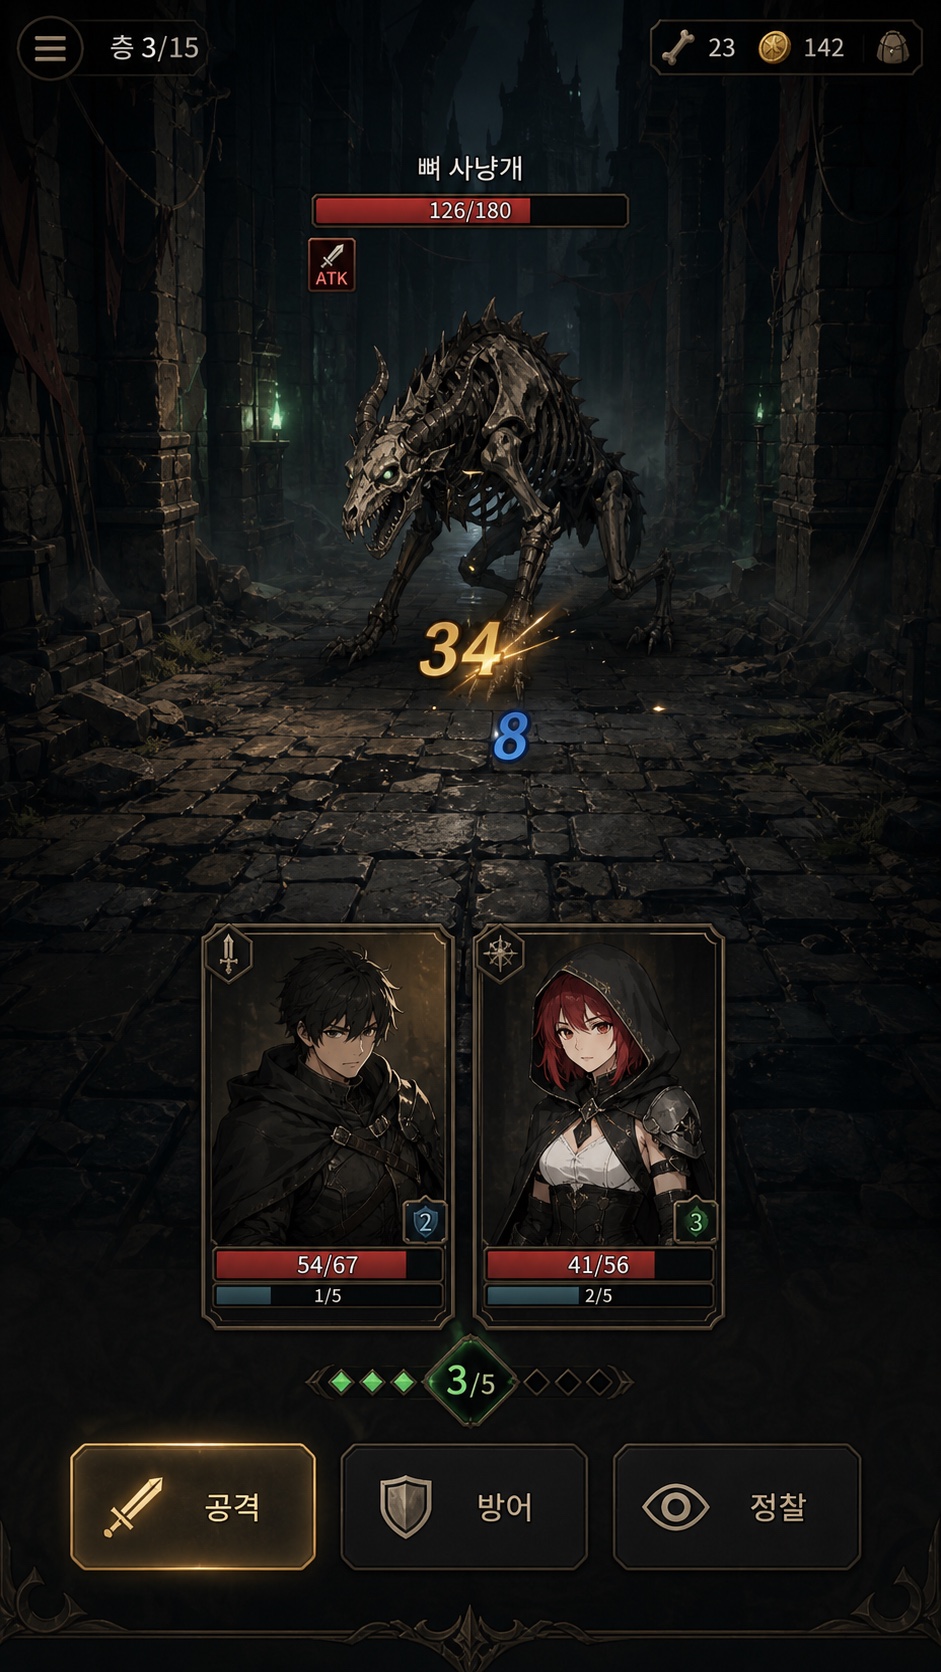
전투 목표
플레이어 피해와 마타이오스 지원 피해가 분리되고, 세로 화면 하단에 전투 command가 명확히 배치된 목표 화면.
루트 목표
희소한 탑 루트, 선택 가능한 노드 glow, 이벤트 선택 패널을 한 화면에서 읽히게 하는 목표 화면.
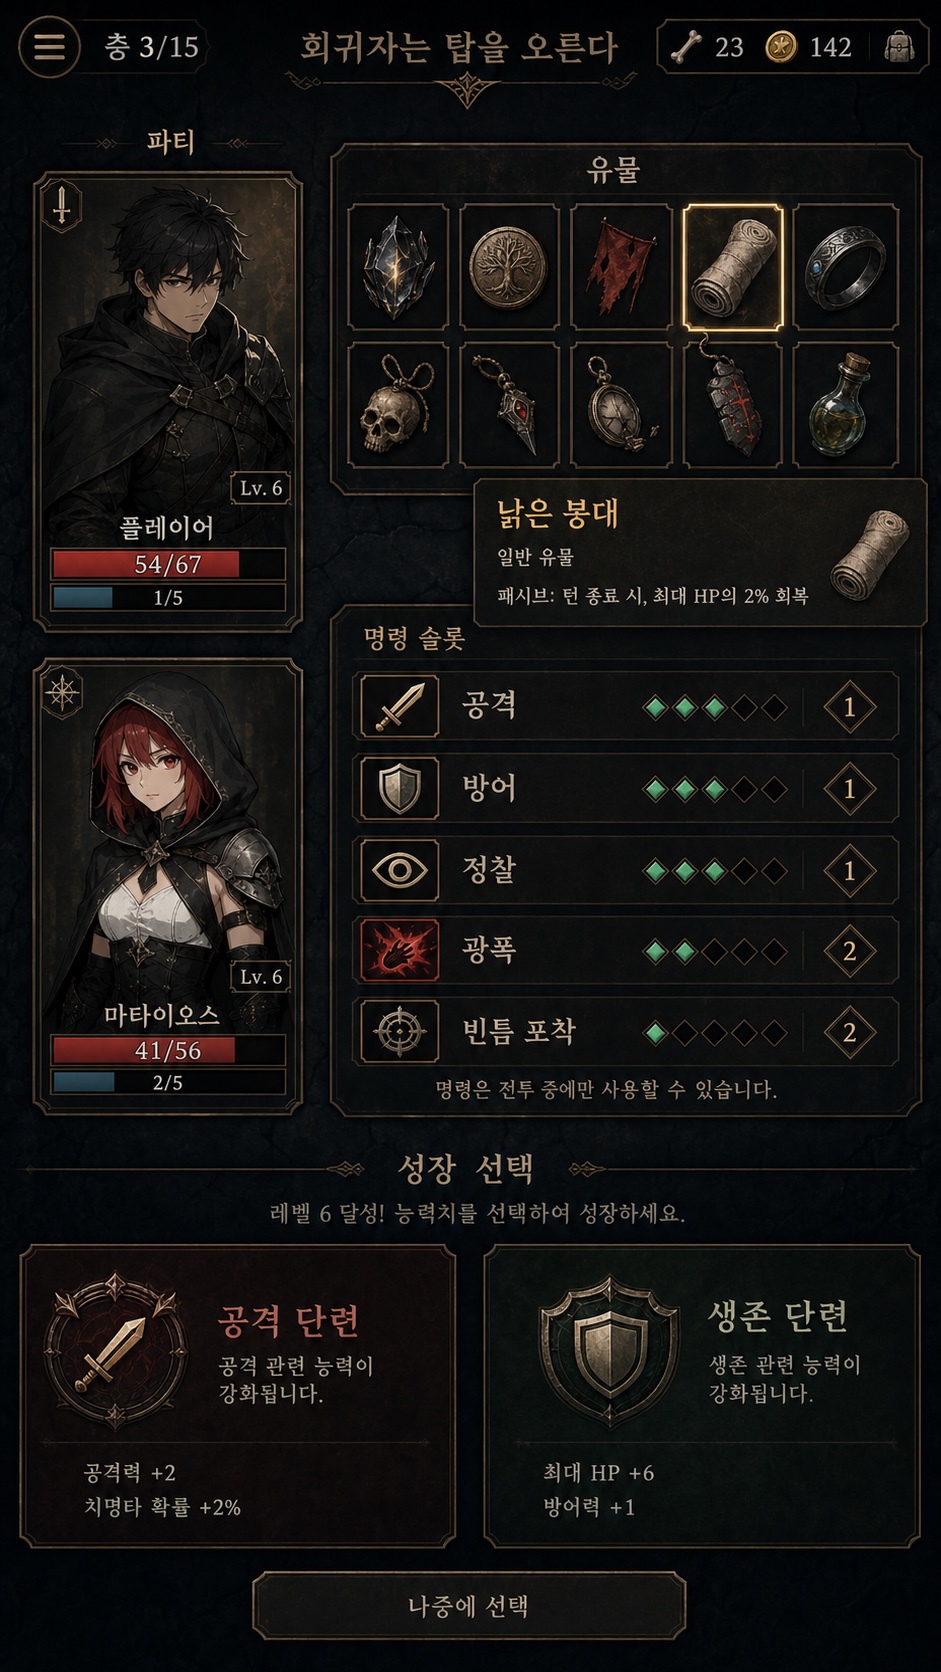
성장 목표
아이템, command slot, 단련 선택을 플레이어가 한눈에 이해할 수 있게 묶은 성장/인벤토리 목표 화면.
리마스터 목표
실제 구현 화면의 기능은 그대로 두고, 정보 위계와 화면 품질을 이 방향으로 다듬습니다. 전투 로그, 피해 분리, 동료 지원, 버튼 위계를 더 잘 읽히게 재정리한 목표입니다.
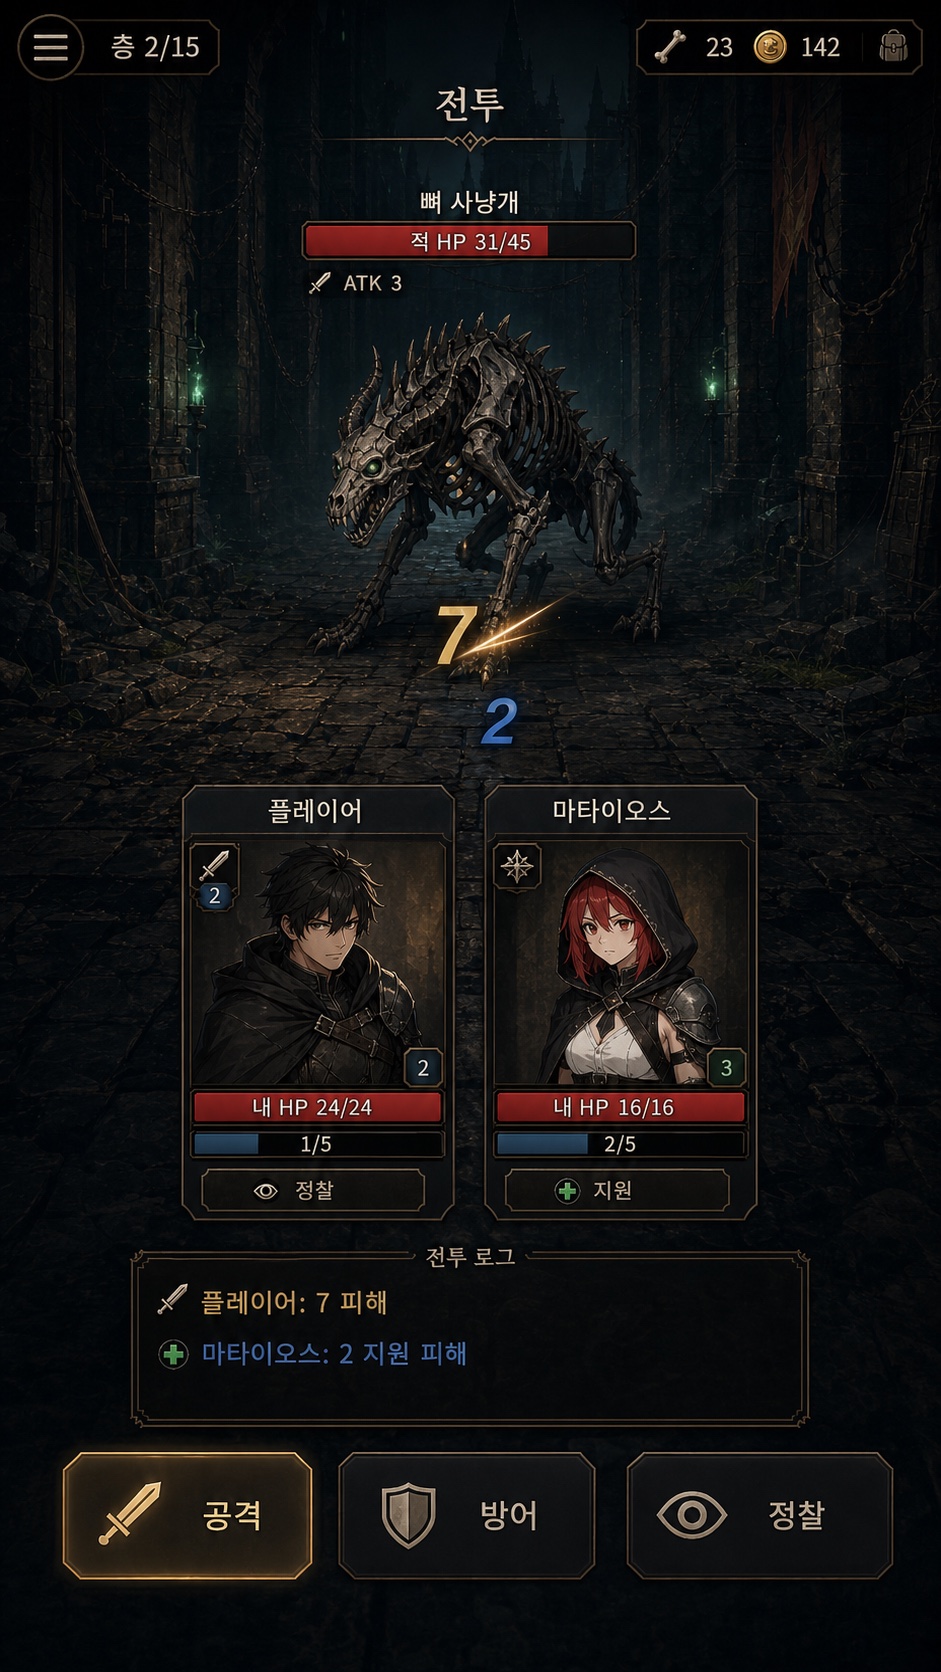
전투 리마스터
전투 로그, 피해 분리, 마타이오스 지원, command button hierarchy를 포트폴리오용 화면 품질로 재정리한 목표입니다.
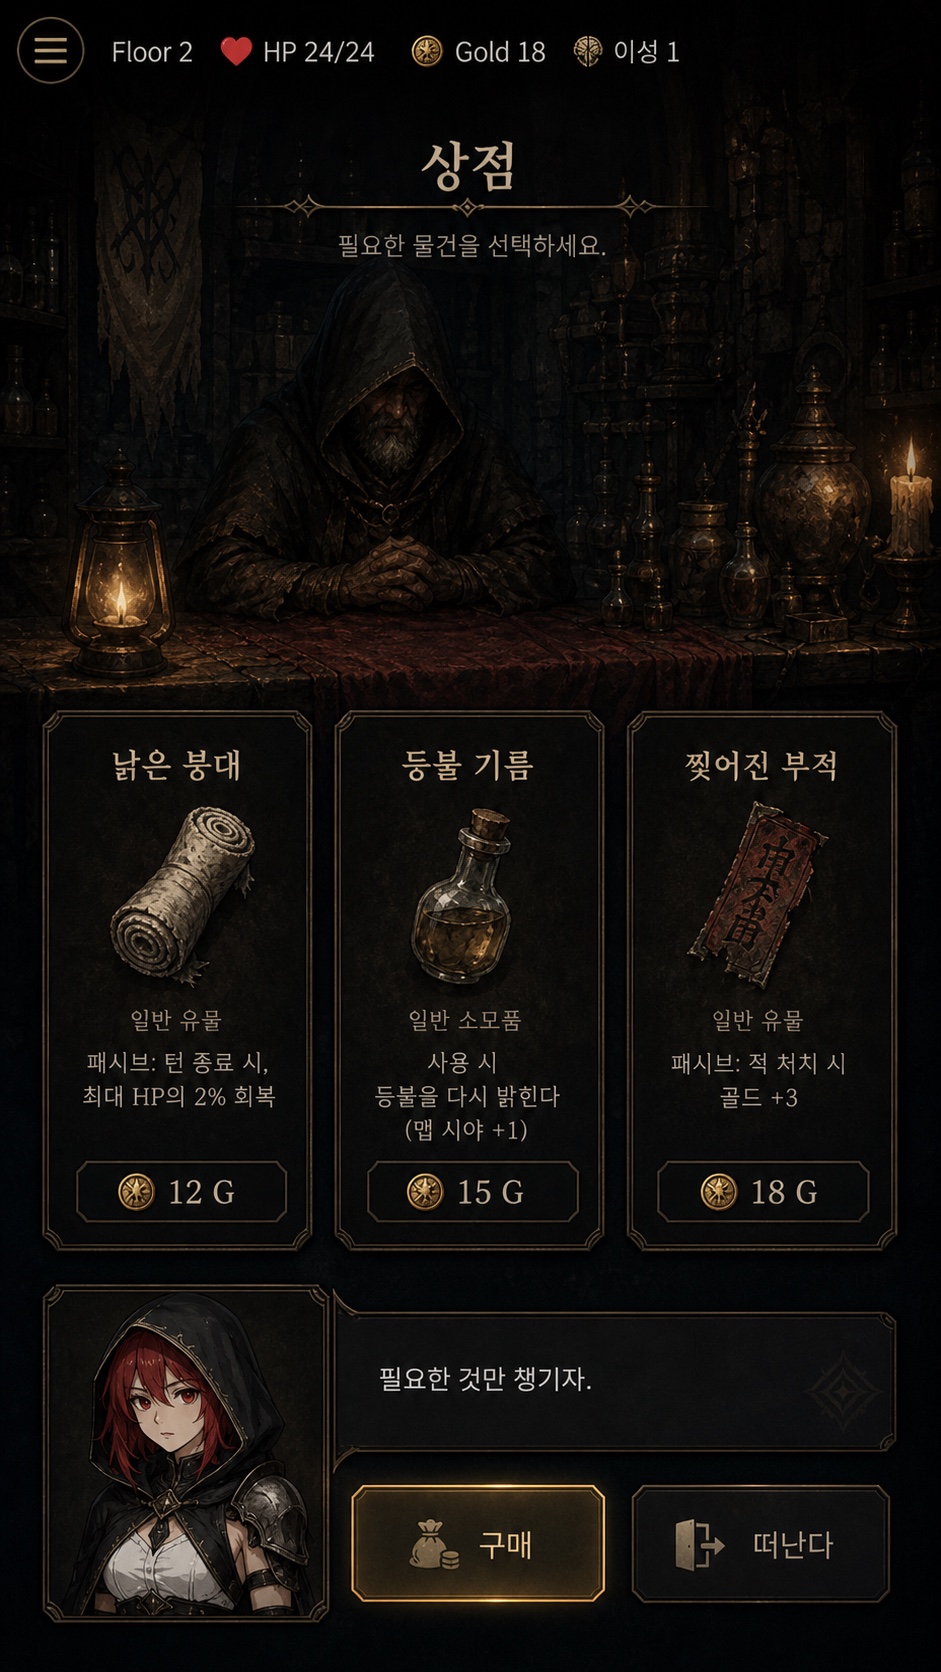
상점 리마스터
상점은 자원 선택과 아이템 효과를 한 번에 읽히게 하고, 동행자 반응을 하단 패널에 붙이는 방향입니다.
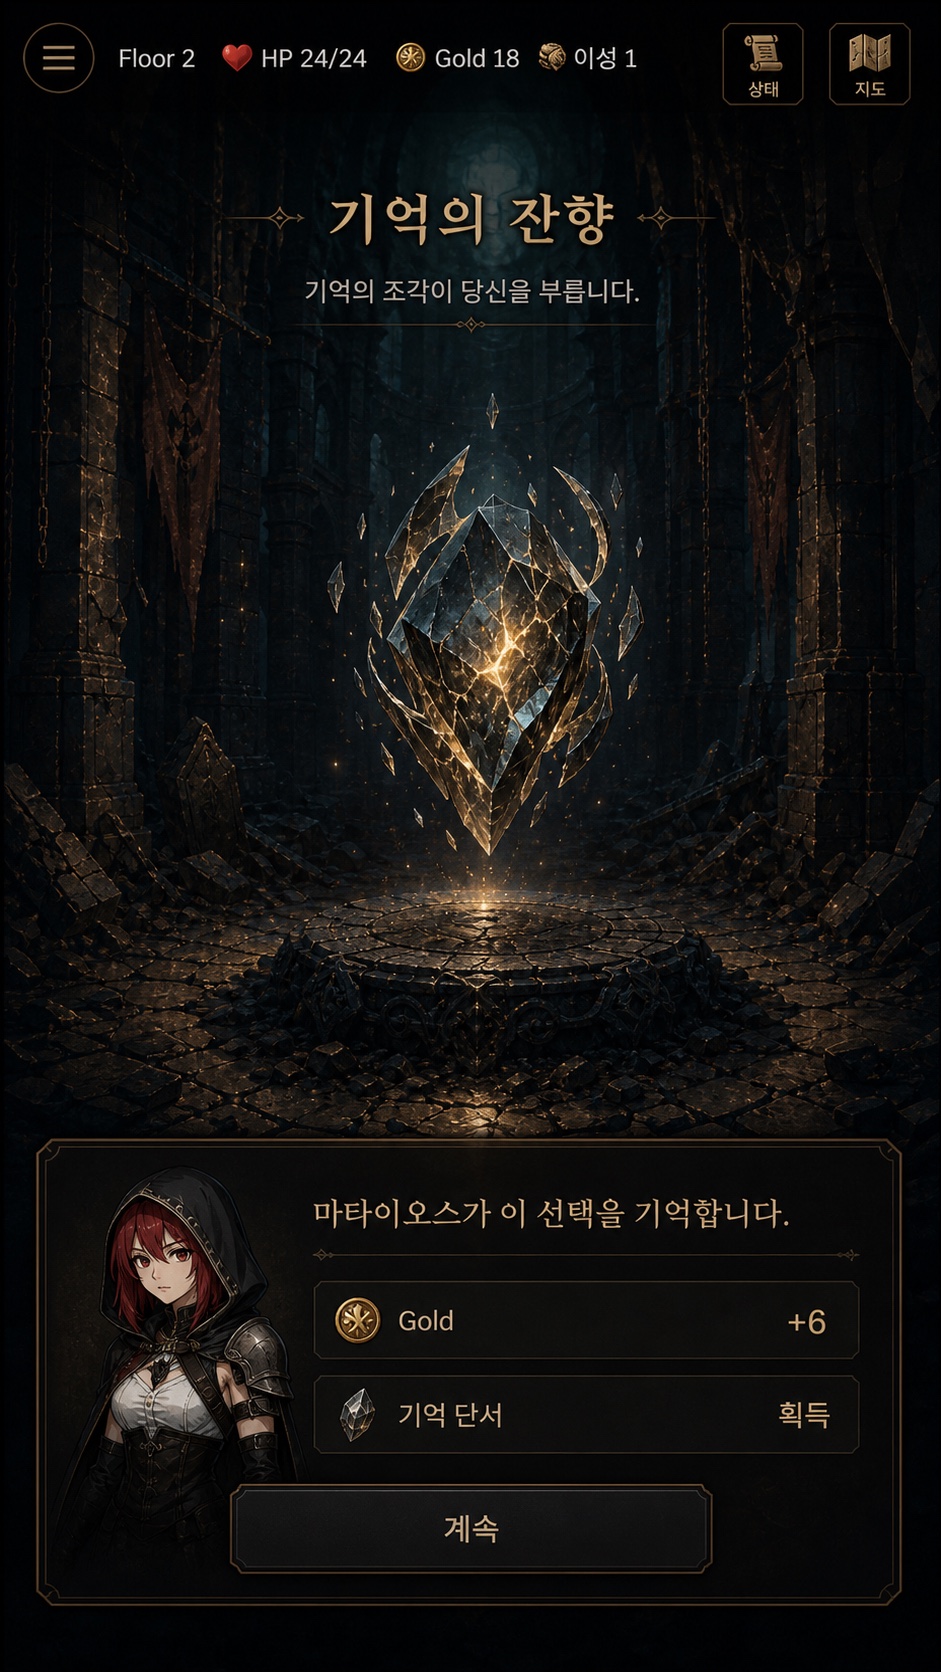
기억 리마스터
기억 이벤트는 raw ref가 아니라 consequence feedback과 보상 row가 중심이 되도록 화면 언어를 정리합니다.
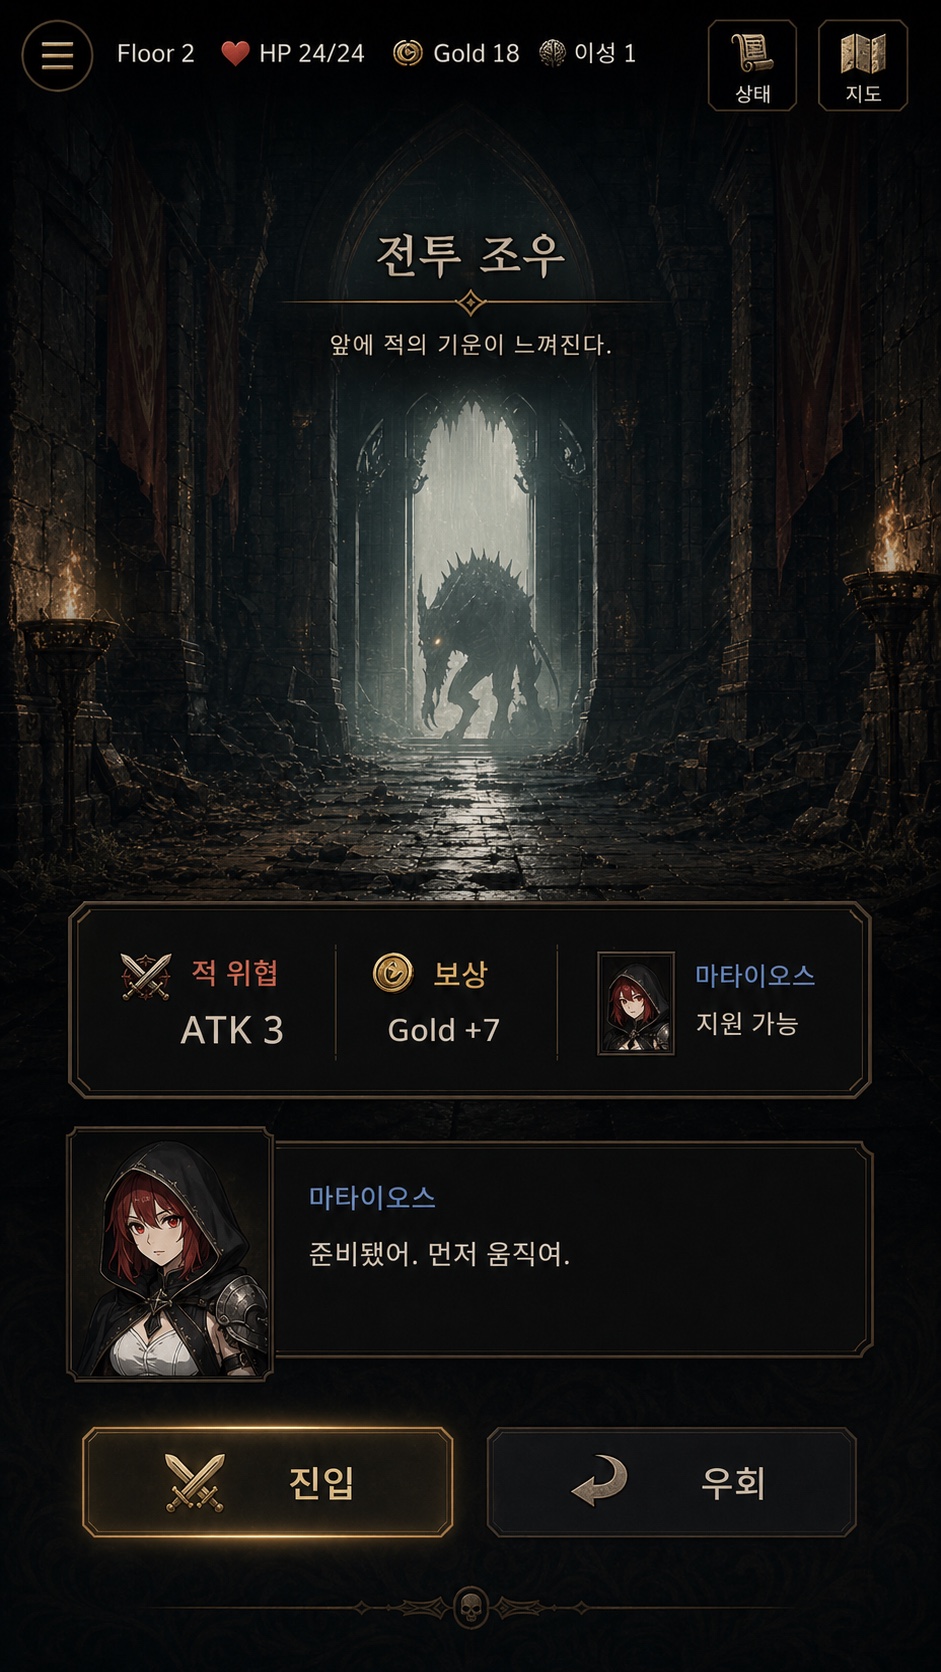
조우 리마스터
전투 진입 전 위협, 보상, 마타이오스 지원 가능 여부를 먼저 읽게 하는 조우 presentation 목표입니다.
01 구현 화면
실제로 동작한 Unity 프로토타입 화면을 구현 증거로 보존합니다.
02 목표 리마스터
화면 품질과 정보 위계의 목표를 빠르게 잡습니다.
03 레이어 분해
배경, 카드, 버튼, 아이콘, 폰트, 피해 숫자를 Unity 레이어로 나눕니다.
04 런타임 캡처
게임에 반영한 뒤 런타임에서 다시 캡처해 최종 화면으로 교체합니다.
실제 구현 화면
아래는 실제로 동작하는 Unity 프로토타입 화면입니다. 기능을 먼저 구현해 검증했고, 여기에 위 목표 비주얼을 얹어 화면을 다듬어 갑니다.
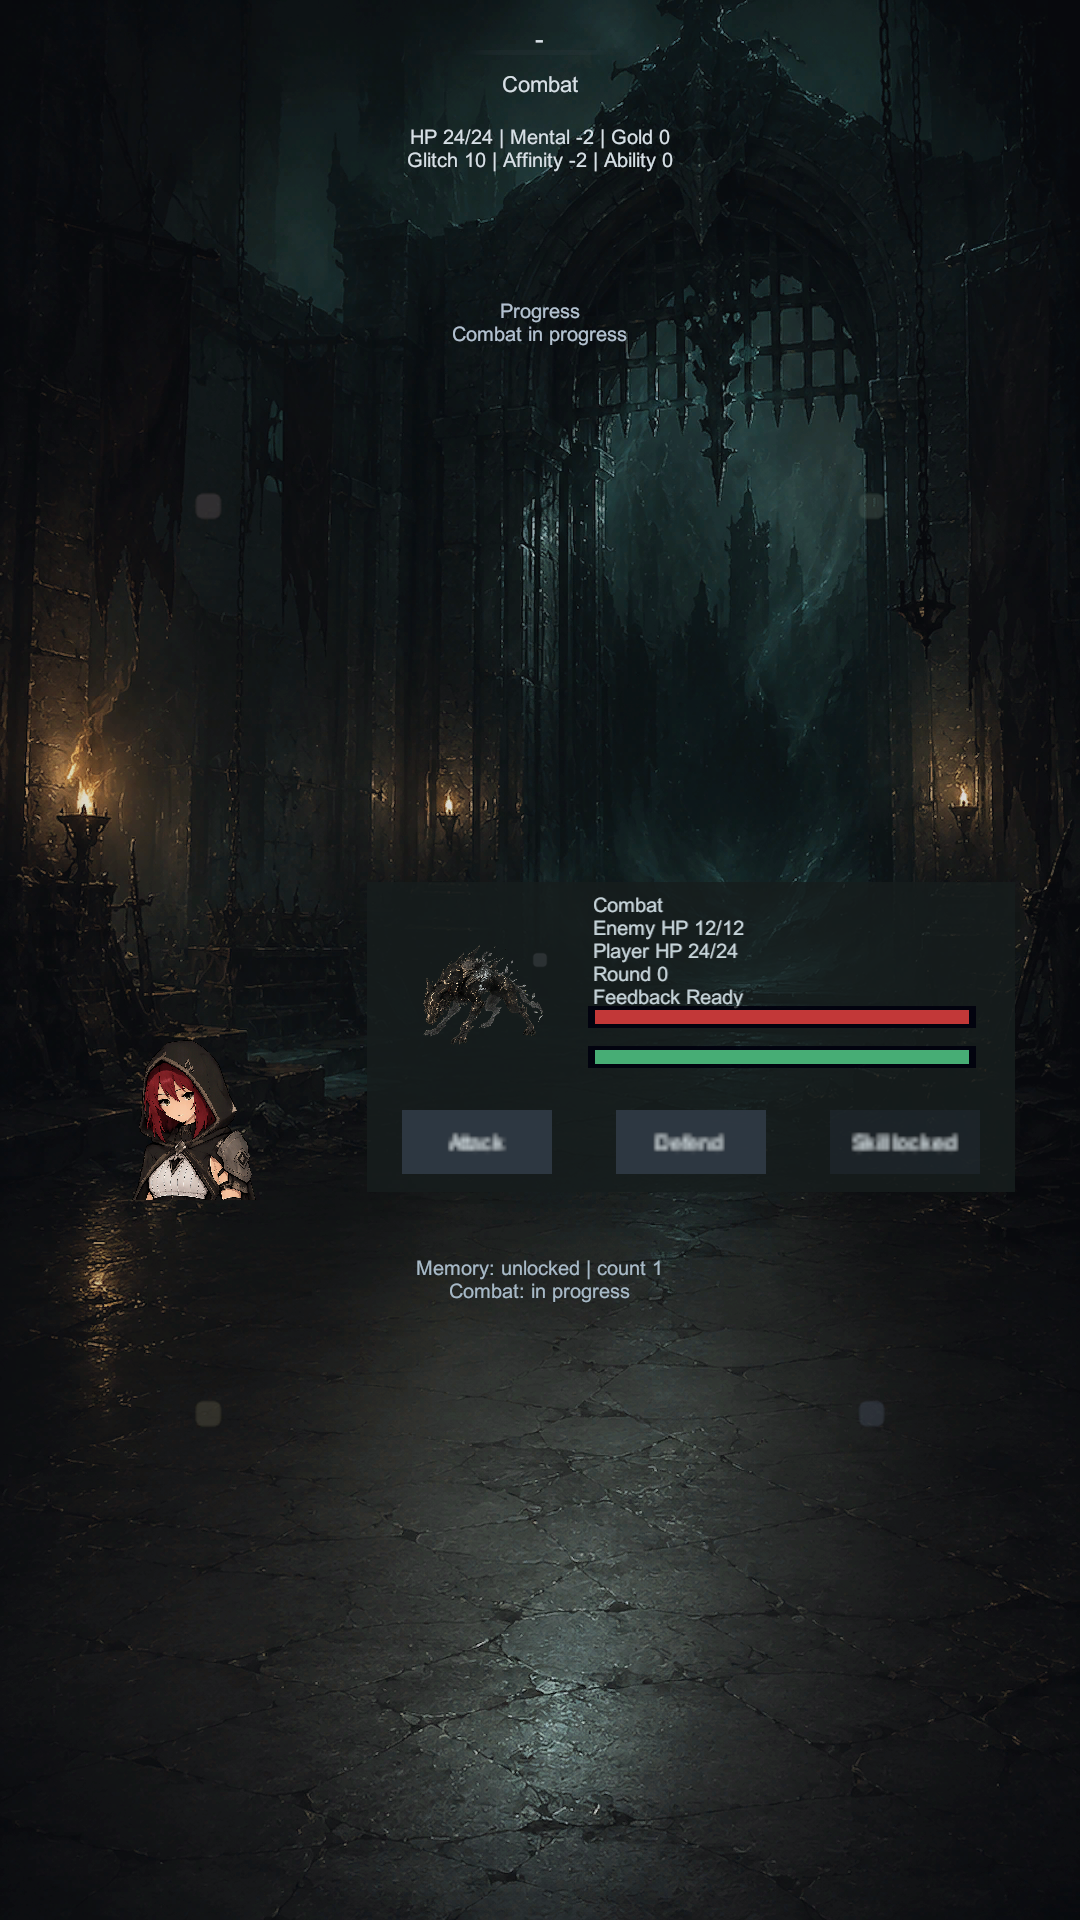
전투 구현
적, HP bar, 플레이어/마타이오스 카드, action buttons가 한 화면에 들어오는 모바일 세로 전투 구조.
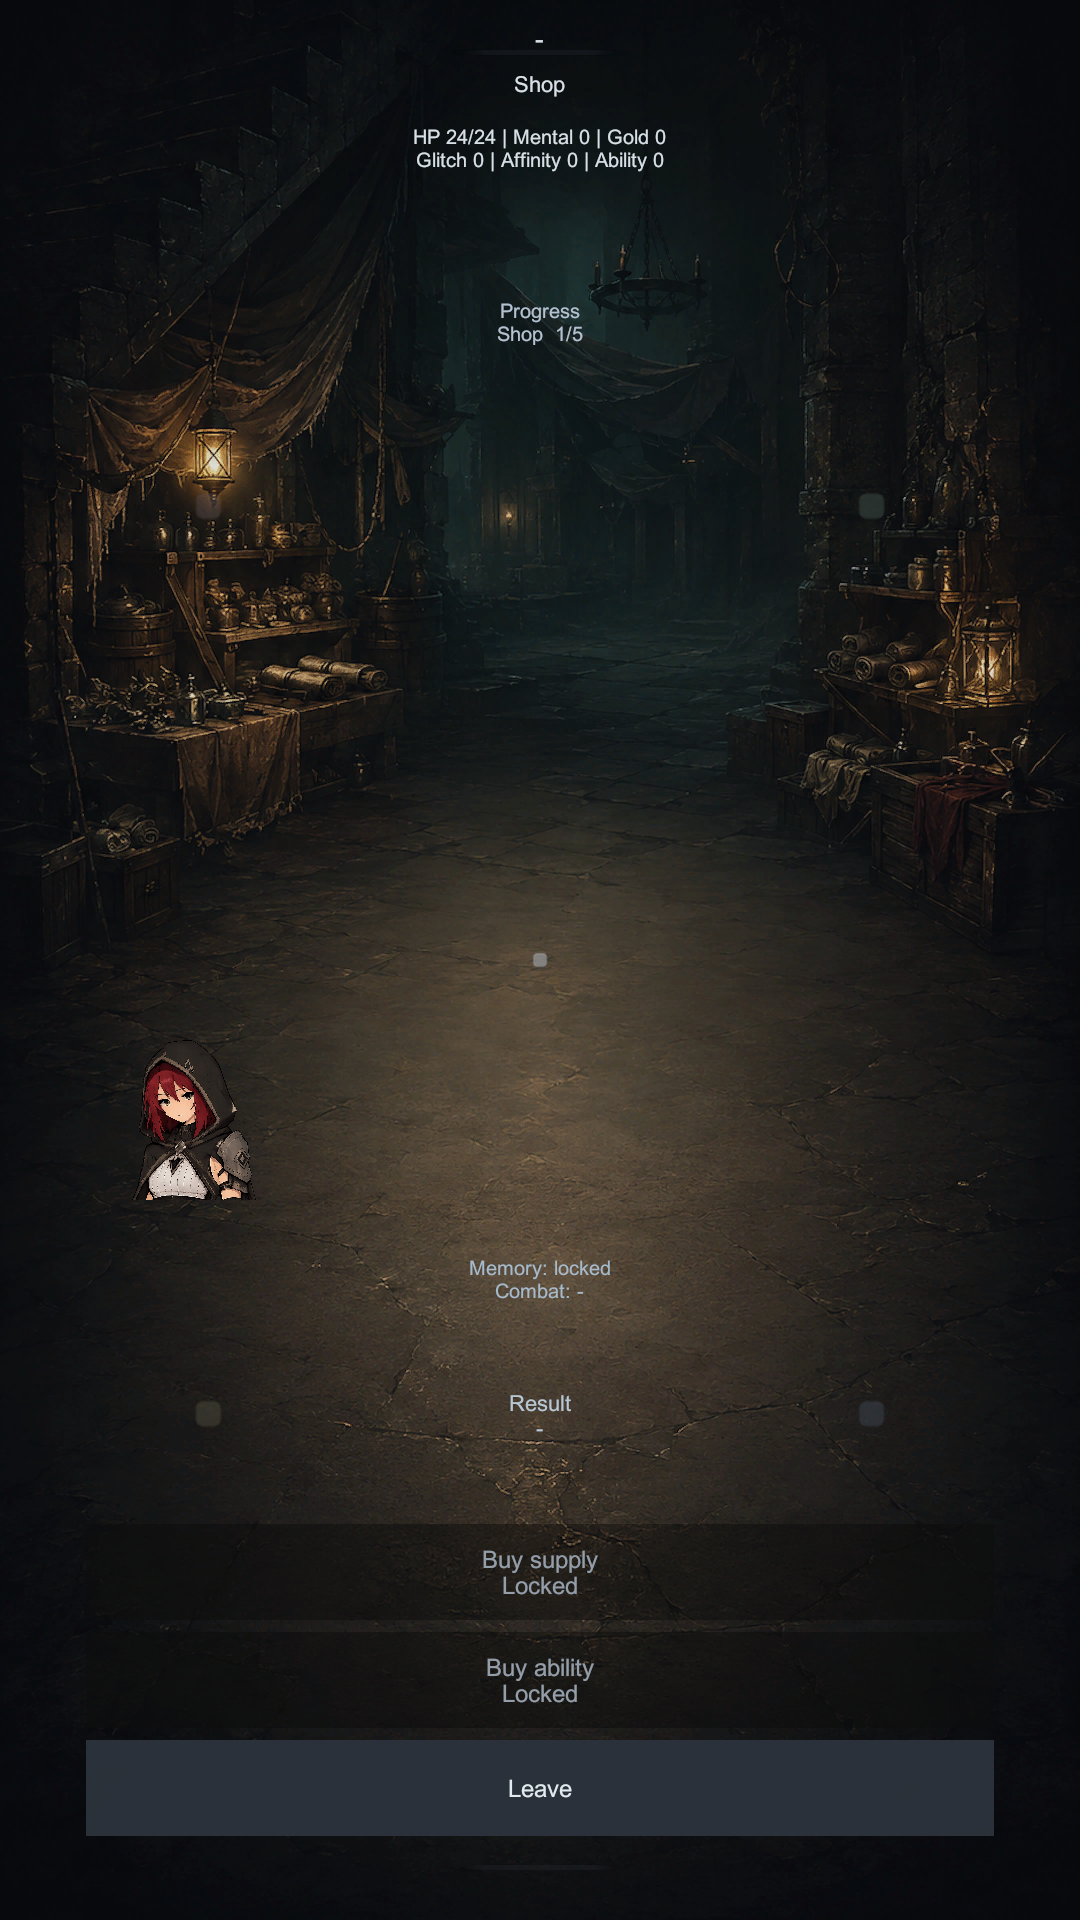
상점 구현
짧은 런 중간에 자원 선택을 끼워 넣는 상점/보급 화면. 전투만 반복하지 않는 리듬 설계 증거.
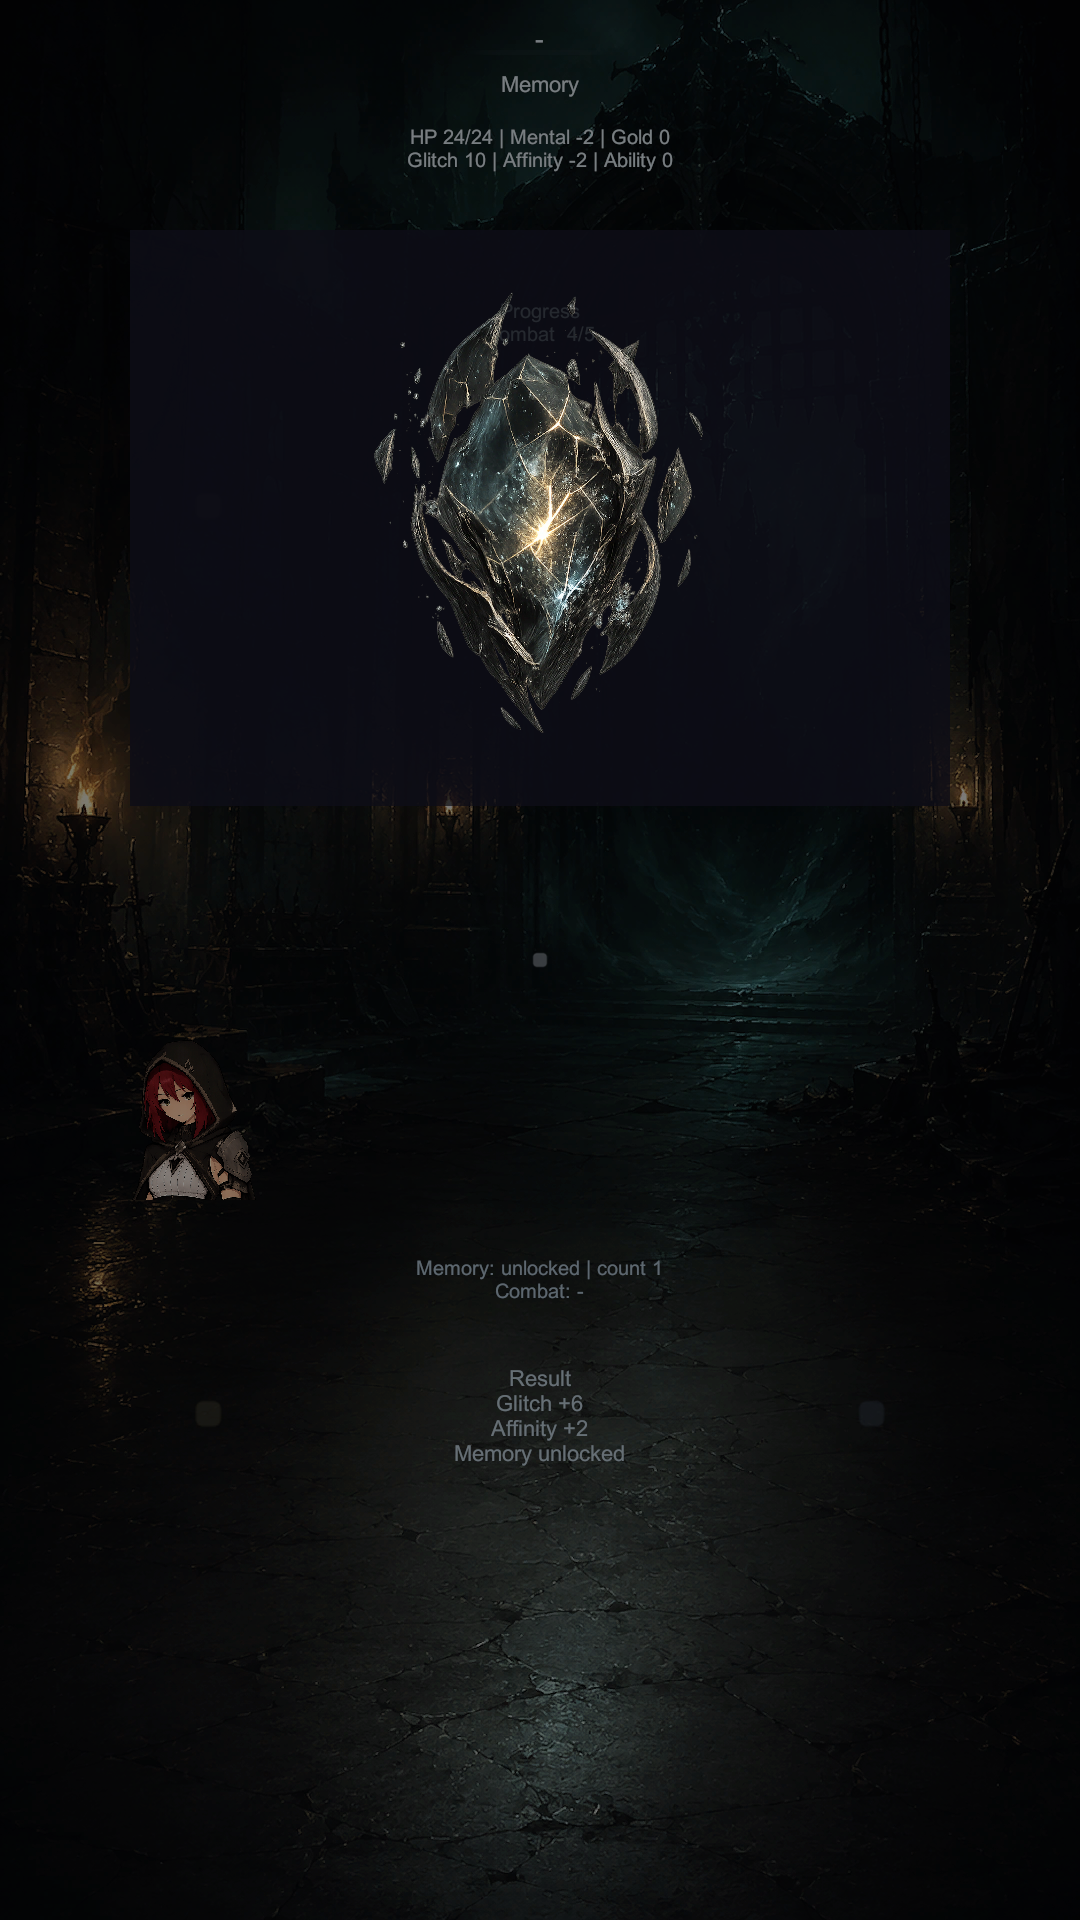
기억 구현
메모리/이벤트는 단순 텍스트 로그가 아니라 배경, 컷신 레이어, 결과 피드백으로 분리해 보여줍니다.
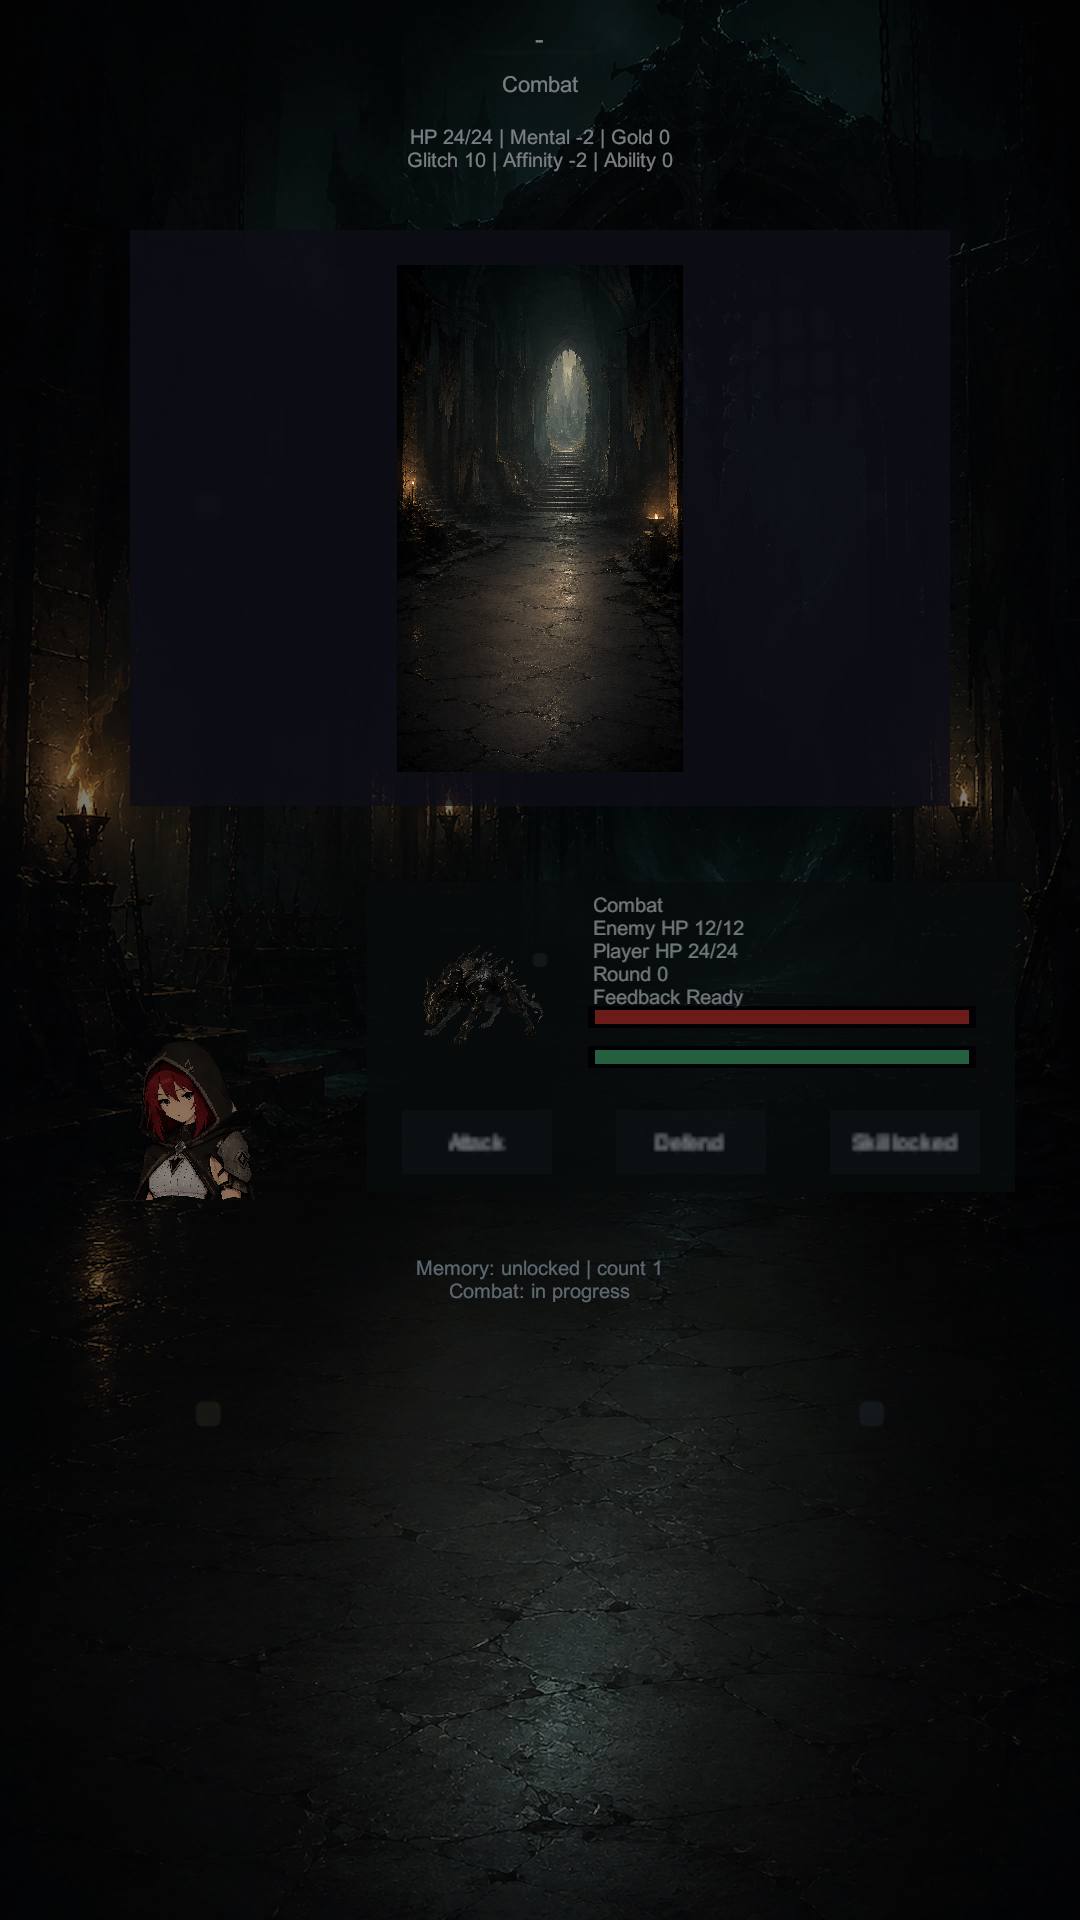
조우 구현
전투 진입 전 presentation layer와 실제 전투 UI를 연결하는 화면. 조우 파이프라인이 화면으로 드러납니다.
목표 화면은 게임에 반영한 뒤 런타임 캡처로 교체할 예정입니다.
동행자, 마타이오스
마타이오스는 "AI 기능"을 전면에 세운 기술 데모가 아니라, 플레이어 옆에서 싸우고 선택을 기억하는 동행자입니다. 강화학습 실험은 본편 runtime에 붙인 것이 아니라, 전투 허점을 찾고 동행자 규칙을 더 선명하게 만드는 설계 도구로 사용했습니다.
마타이오스는 캐릭터다. 모델 자랑이 아니다.
전투에서는 보호, 지원, 마무리 판단을 수행하고, 이벤트에서는 플레이어의 선택을 기억합니다. 플레이어는 마타이오스가 실제로 옆에서 싸우고 반응한다는 감각을 받아야 합니다.
AI를 전투 설계 점검 도구로
- 문제
- 초기 전투는 AttackSpam / SkillSpam 같은 지배 전략이 생기기 쉬웠고, 마타이오스의 존재감도 UI 장식처럼 보였습니다.
- 실험
- ML-Agents 실험은 shipped AI가 아니라 전투 설계 실험장입니다. reward, defend payoff, skill gate를 바꿔 degenerate strategy를 드러냈습니다.
- 발견
- Exp04에서 PPO가 spam baseline을 명확히 넘었지만, ContextPolicy가 더 안정적이었습니다. 그래서 ONNX 연결이 아니라 사람이 읽을 수 있는 deterministic rule로 환원했습니다.
- 런타임
- 본편 마타이오스는 runtime RL/ONNX가 아닙니다. `MataiosCombatBrain`은 명시 규칙으로 보호, 지원, 마무리, 안정화 행동을 결정합니다.
+0.32
Exp04 스팸 정책 대비 보상 격차
0.27
PPO 방어 행동 비율
2.10
결정론 ContextPolicy 보상
강화학습을 검은 상자 기능이 아니라 설계 검증 장치로 사용
이 프로젝트의 AI 강점은 학습 모델 과시가 아닙니다. AI 실험으로 전투 규칙의 빈틈을 찾고, 그 결과를 플레이어가 이해할 수 있는 동행자 행동 규칙과 UI 피드백으로 바꾼 점입니다.
별도 케이스 스터디에서는 마타이오스 대화를 위해 EXAONE 3.5 2.4B, QLoRA, FastAPI, Unity를 연결한 AI NPC 훈련 과정을 정리했습니다. 전투 RL과 대화 모델 파인튜닝을 섞어 과장하지 않고, 각각의 목적과 검증 지표를 분리해 보여줍니다.
콘텐츠와 시스템 설계
포트폴리오의 핵심은 "좋아 보이는 아이디어"가 아니라, 제약 안에서 시스템을 구현 가능한 단위로 쪼갠 흔적입니다. 아래 항목은 기획 의도, 플레이어 경험, 데이터 구조, UI 피드백이 어떻게 연결되는지 보여줍니다.
희소한 3-lane 지도와 되돌릴 수 없는 노드 선택
매 층은 전투, 이벤트, 휴식, 상점, 보스까지 이어지는 짧은 루트로 구성됩니다. 미래 노드는 타입을 보여주되 비활성화해, 플레이어가 위험과 보상을 미리 보고 고르게 만듭니다.
버튼 연타가 아니라 판단 cue가 있는 전투
공격, 방어, 스킬은 예상 피해와 방어 가치, 쿨타임을 보여줍니다. 최근 작업에서는 중압 방어, 빈틈 스킬, 정찰 공격 같은 판단 라인을 추가해 다음 행동을 읽기 쉽게 만들었습니다.
동행자가 전투에 참여하는 감각
마타이오스의 피해와 플레이어 피해를 합치지 않고 분리 표시합니다. 플레이어가 싸우는 동안 동행자가 보호하거나 지원하는지 로그와 UI에서 확인할 수 있게 했습니다.
33개 이벤트 화면과 138개 선택지 파이프라인
이벤트는 배경, 선택지, 결과, 보상, 기억 반응을 데이터로 연결합니다. raw label 노출, 누락 배경, 미지원 효과 같은 문제를 정적 검증과 핫픽스로 반복 제거했습니다.
레벨업 보상, 스킬 정리, 5 command slots
정찰은 즉시 큰 피해가 아니라 다음 공격 강화와 1회 피해 감소로 조정했습니다. 공격/방어 기본 장착, 액티브 스킬 교체, 단련 보상으로 성장 표면을 만들었습니다.
피해 숫자, 흔들림, 처치 지연, 보스 보상 팝업
유저 피드백을 받아 전투 시작 버튼을 제거하고, 전투 진입 암전, 피격 흔들림, 격파 표시, 보스 보상 팝업을 추가했습니다. 결과는 즉시 사라지지 않고 약 2초간 처치 피드백을 먼저 보여줍니다.
왜 이 방향인가
회복, 붕괴, 망각이라는 주제를 플레이 규칙에 묶었습니다. 회복만 주는 보상은 피하고, 선택이 다음 위험과 동행자 반응으로 이어지게 설계했습니다.
5분 런 + 누적 회차
짧은 세션에서는 즉각 보상과 명확한 피드백을 주고, 누적 회차에서는 기억·도덕 선택·동행자 변화로 무게를 쌓는 구조입니다.
모바일 세로 화면 우선
상단 HUD를 줄이고, 전투 판단 정보를 버튼 근처에 배치하고, 이벤트/결과/보상은 중심 영역에서 먼저 읽히게 반복 조정했습니다.
콘텐츠 확장 가능한 조우 구조
이벤트, 선택지, 보상, 기억 반응은 데이터와 resolver를 통해 연결합니다. 누락 ref, raw label, 미지원 효과는 validation 대상으로 관리했습니다.
기획 관점으로 다시 보기
실제 기획 포트폴리오 관점에서는 "무엇을 만들었다"보다 "어떤 플레이어 문제를 어떤 규칙과 UI로 해결했는가"가 중요합니다. 이 페이지는 구현물을 아래처럼 기획서 평가 언어로 다시 번역합니다.
플레이어 문제: 선택지가 많아 보이지만 실제 의미가 흐려지는 dense map.
기획 해법: 3 sparse lanes, face-up future node, skipped route lock, node tap 즉시 commitment.
플레이어 문제: 공격 버튼만 반복해도 이기는 damage race.
기획 해법: 행동 preview, 판단 cue, 정찰 재정의, player/Mataios 피해 분리, 처치 후 2초 피드백.
플레이어 문제: 선택 결과가 늦거나 raw label처럼 보여 몰입이 끊기는 상태.
기획 해법: 33개 presentation slot, 138개 choice resolution, memory consequence feedback, raw label hide.
플레이어 문제: NPC가 같이 있는지, 전투에 참여하는지 체감하기 어려운 상태.
기획 해법: deterministic companion brain, 보호/지원/마무리 역할, combat log attribution, no runtime RL marketing.
"AI를 검은 상자 기능으로 붙인 것이 아니라, 반복 플레이의 허점을 찾고 전투 규칙을 고치는 설계 디버거로 사용했다."
AI를 활용한 제작 방식
이 포트폴리오에서 가장 강한 지점은 결과물 자체와 함께, 그 결과물이 만들어진 방식입니다. 세션 분리, clean worktree, CodeGraph preflight, evidence freeze, APK artifact gate를 사용해 "바이브코딩"을 검증 가능한 개발 파이프라인으로 바꾸려 했습니다.
포트폴리오 증거
- AI 검증
- ML-Agents는 본편 런타임이 아니라 전투 설계 실험장으로 썼습니다. Exp04에서 PPO가 스팸 baseline을 넘었지만, 결정론 ContextPolicy가 더 안정적인 후보임을 확인했습니다.
- Runtime
- 본편에는 ONNX/RL을 연결하지 않았습니다. 마타이오스는 규칙 기반 companion brain으로 처리해, 캐릭터 경험과 기술 검증을 분리했습니다.
- 배포
- Android APK는 package, label, arm64 ABI, v2 signature, SHA-256을 함께 보고하는 방식으로 관리했습니다.
- 리스크
- Unity Test Runner baseline issue, device smoke N/A, authored route regression 등은 통과로 포장하지 않고 별도 risk bucket으로 분리했습니다.
지도, 전투, 동행자 역할을 결정 문서로 먼저 잠금
D-034 route commitment, D-035 companion brain, D-036 combat preview, D-038 command cleanup처럼 구현 전 계약을 분리했습니다.
작은 배치로 구현하고 APK까지 반복 배포
UI batch, combat fun rebuild, event integration, route/content hotfix를 작은 단위로 나누어 push와 APK artifact를 만들었습니다.
Targeted tests와 사용자 smoke를 분리
자동 테스트로 막을 수 있는 regressions와 실제 폰에서만 보이는 readability 문제를 구분해, 각각 다른 gate로 처리했습니다.
피드백을 기능이 아니라 플레이 감각으로 번역
"전투가 재미없다"는 피드백을 피해 분리, 처치 피드백, 보스 체력, 스킬 의미, 성장 UI, command slot으로 나눠 고쳤습니다.
현재 빌드 정보
아래 정보는 현재 포트폴리오 페이지 작성 시점의 확인 가능한 빌드/문서 상태입니다. "완성 출시"가 아니라, Android playable candidate와 개발 사례를 보여주는 포트폴리오 기준입니다.
플레이 가능 후보
- Commit
- 7ac43be5ae9aab8f73832430aaf78ea68e0177d0
- SHA-256
- 08ca2014c2f08bfeb06dcf8d28c46f97ece806be151efc735586fa195e95c932
- Android
- com.godju.hwigitower / 회귀자는 탑을 오른다 / arm64-v8a / APK Signature Scheme v2 verified
정식 출시 전 프로토타입
현재 목표는 상용 출시 페이지가 아니라, playable prototype과 기획/구현/검증 역량을 명확히 보여주는 대외 포트폴리오입니다.
Unity 테스트 baseline 이슈
일부 Unity Test Runner는 baseline package compile issue로 XML 결과를 만들지 못했습니다. Android build와 targeted 검증은 별도로 보고되었습니다.
공개용 캡처 보강
전투·이벤트·지도·성장 화면의 실제 플레이 캡처를 선별해 보강할 예정입니다.